|
|
从 SDCC-C251 到 MX251:一次面向实际工程的编译器优化探索
大家好,分享一下 MX251 最近的开发进展。这次主要谈架构改革、版本演进和实板结果,也把走过的弯路一起列出来,欢迎对 MCS251 编译器、ABI、寄存器分配和工程验证感兴趣的朋友交流。
MX251 是开源项目 MCU StudioX 下,面向 MCS251 的开源编译器子项目。目前仍处于优化和验证阶段,完整编译器开发版本、配套运行库和 SDK 暂不公开发布;本帖先公开相关技术细节和阶段性实验结果。
MCU StudioX 的 GitHub 地址:
https://github.com/XieJunHui9566/MCU-StudioX
请注意:上面是 MCU StudioX 的公开项目地址,目前克隆该仓库并不等于能取得本文所测的完整 MX251 编译器。开源项目定位、当前源码发布范围和正式发行资格需要分别说明。
本文整理自项目源码、构建契约及 145 份编号版本报告,关键结果来自已归档的真实开发板测试。本帖不是新一轮实板实验;证据截止 2026 年 10 月 31 日,SDK 部分固定使用当日 11:39 的状态快照。后续候选还在变化,不能把本文数值套到任意“最新版本”上。
一、MX251 继承了什么,又改了什么?
MX251 基于 SDCC-C251 演进,保留 SDCC 的 C 前端、AST/iCode 和公共优化基础,并沿用配套汇编、链接体系。编译器核心主要使用 C/C++,运行库和启动代码使用 C/汇编,构建与验证使用 CMake、Ninja、PowerShell、Python 等工具。
本文所说的“初始 SDCC-C251”,特指归档的 gevico/sdcc-c251 基线:
发布标识:v4.6.0-mcs251-20260804
提交:b09075b6a93e6afe10645181e3aeff041ea37f87
它是固定历史对照,不代表今天 SDCC 主线或该分支最新版本的能力。
改革重点是让 MCS251 的宽寄存器、调用约定和地址空间进入后端决策,并把优化结果落实到完整工程。这里的 MIR 是 MX251 后端使用的机器级中间表示,不能理解为采用了 LLVM,也不是从零重写了整个 C 编译器。
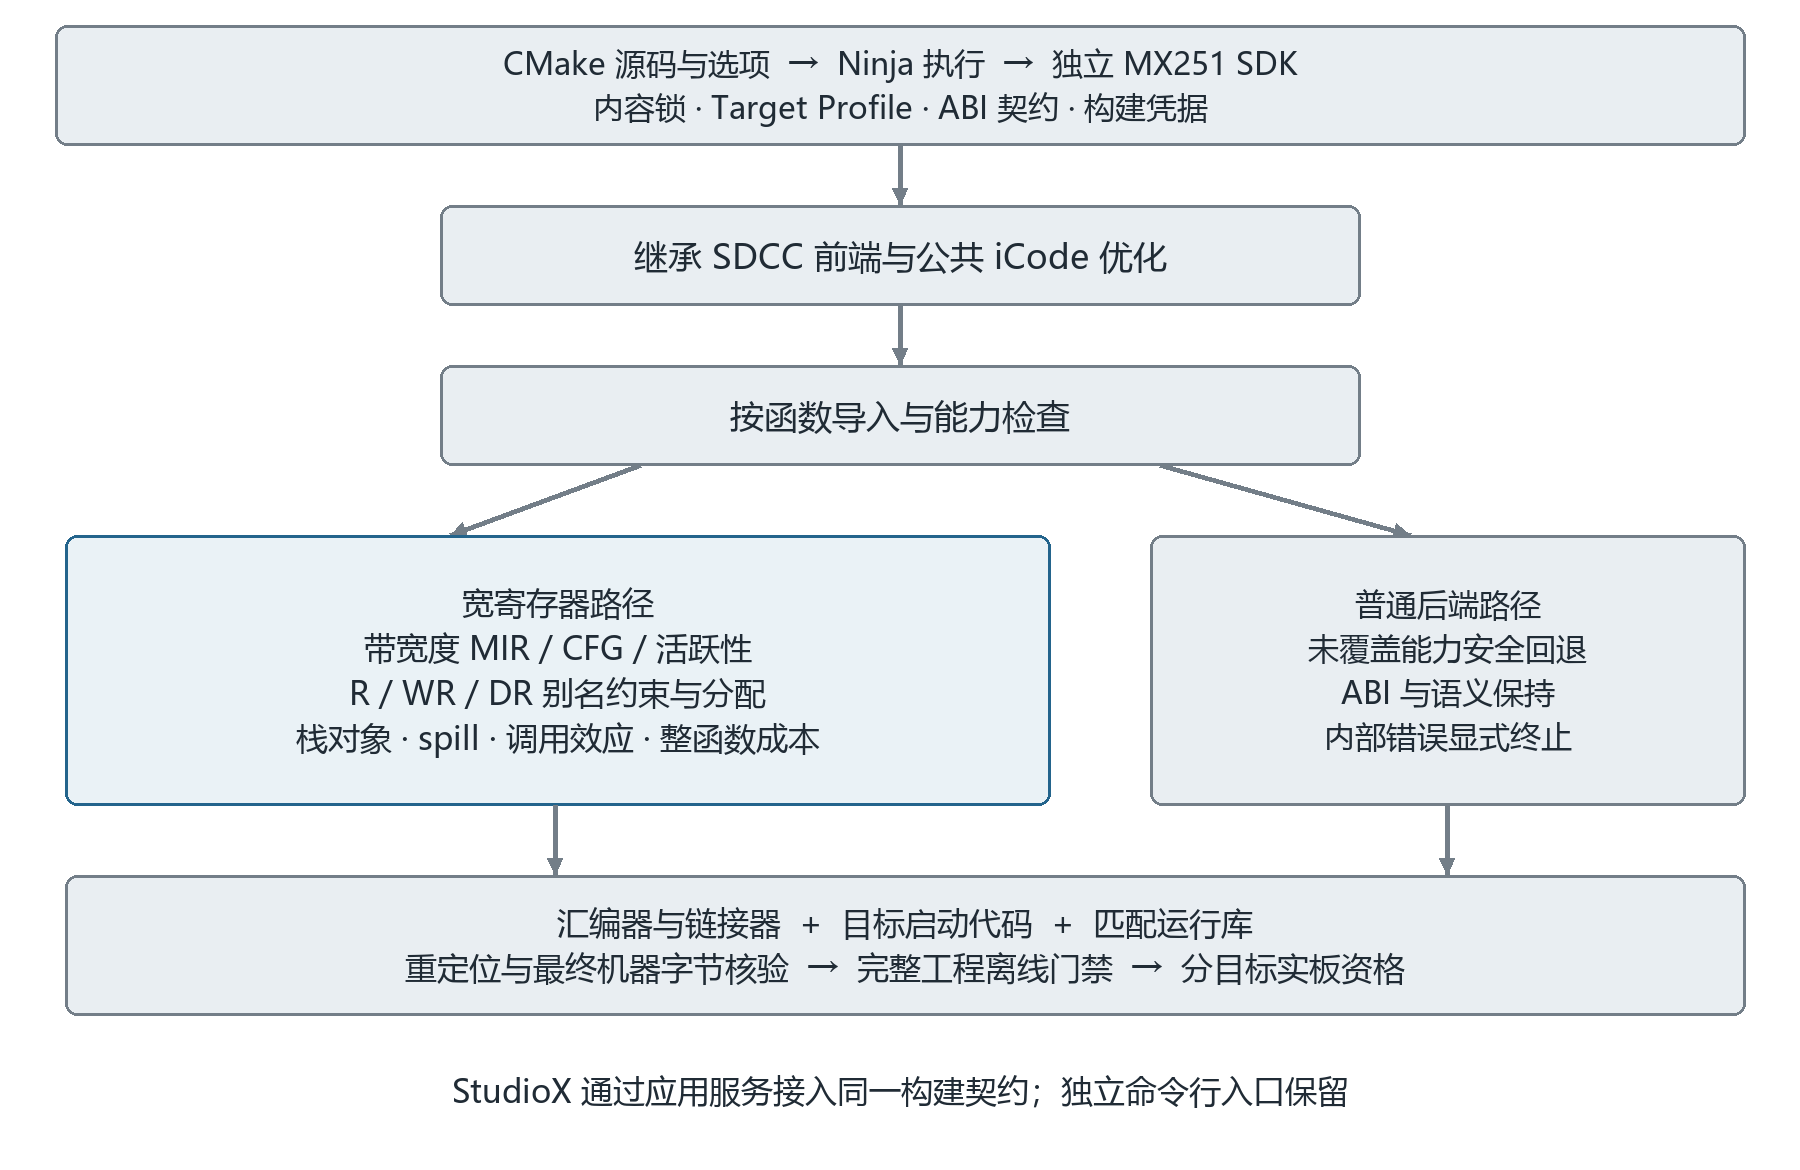
图1:MX251 的编译架构。宽后端与普通后端共享前端基础,最终通过同一工程构建和验证链路。
1. 从局部宽指令替换,发展为带宽度的独立后端
早期主要在原有生成流程中选择原生 16/32 位指令,但原来的分配和搬运方式仍可能抵消宽指令收益。后续引入按函数导入的宽后端,将值的宽度、控制流、活跃性、寄存器干涉、溢出到栈和指令生成放进同一处理流程。
MCS251 的 R/WR/DR 是重叠的物理寄存器视图,不能把它们当成互不相关的寄存器池。例如 A 与 R11、B 与 R10 的别名必须共同建模。宽值只有在对应物理字节均可用时才能分配,调用破坏集合也必须遵守这些重叠关系。
24 位指针可以在内部以 32 位值承载,但存储和 ABI 仍要保留三字节语义。未覆盖的能力按函数安全回退;编译器内部错误需要显式报错,不能靠静默回退掩盖。
2. 按对象和生命周期处理栈、指针与地址
优化从“删掉一条看起来重复的地址指令”,发展为追踪栈对象归属、偏移、地址来源及存活范围。保存现场和传参会改变栈深,对可取址局部量、CODE 读取、far 数据访问等情况,都需要明确语义后才能复用地址。
一个有效方向是尽早完成合法的内存读取,缩短地址值在热路径中的存活时间,减轻它和算术值争抢寄存器的压力。未知指针、volatile、MMIO 和有序 SFR 访问必须保守处理,不能为了减少搬运而删掉真实访问。
3. 显式 ABI 与可校验的跨函数信息
普通 ABI2 与原生 ABI4 分开管理。原生 ABI4 的第一参数按宽度使用 R7/WR6/DR4,第二参数使用 R15/WR14/DR12,其余参数遵守栈传递规则;不同 ABI 使用可区分的符号,防止静默混链。
后续还引入受限的两遍叶函数调用效应反馈:先取得实际寄存器破坏信息,再在源码、工具、选项、ABI 和产物绑定一致时减少调用保存。未知调用和过期信息保持保守处理。它不是运行时性能采样,也不等同于通用全程序 LTO;该功能默认关闭,实验中的 ON/OFF 指此反馈开关,不是 MDU32 开关。
4. 成本模型必须看到整个函数和热循环
函数入口/出口保存、栈帧、参数搬运、spill 和实际指令编码,都影响收益。减少静态 MOV 条数或代码字节,不一定减少真实运行时间;如果把循环外工作搬入热循环,程序反而可能变慢。
因此,成本选择逐步加入循环与条件路径约束,并永久保留失败候选。模型既要拒绝已知负例,也要保住有效正例,不能通过关闭优化或给基准函数写专门规则来“通过回归”。
5. 从独立编译器走向可复核的完整工程链
MX251 保持“CMake 管理工程源码、包含目录和宏,Ninja 执行构建,MX251 编译链接”的入口。MCU StudioX 是宿主之一;其他编辑器或命令行提供匹配 SDK 和工具路径后,也应使用同一构建规则。当前独立 SDK 宿主验证范围是 Windows x64,不能据此声称 Linux/macOS 已完成验证。
Target Profile 管理目标启动、内存、能力和匹配运行库。优化按 IR/ABI/目标能力及成本选择,避免按某个芯片或 SDK 名称复制特判。完整工程还要核对启动根、ISR、函数指针和库引用闭包、最终重定位与机器字节,并记录函数回退原因。AI8051U 的通过不能代替 STC32G 的实板资格。
二、发展过程:局部收益如何转化为工程收益?
历史 R1~R18 以原生宽指令和运行库改进为主;R19~R29 逐步引入栈对象、字节切片、宽寄存器保存和原生 ABI;R30 建立独立宽后端,随后扩展调用、递归、地址空间与工程能力。后续版本改用 V0.xxxx 命名,继续推进调用效应、成本模型、链接闭包和 SDK 覆盖。R 是历史轮次,不是当前的正式版本命名。
先看四类固定完整工程的历史体积变化:
| 完整工程 | 初始 SDCC-C251 | MX251 R89 | Keil C251 | | Math | 25,294 B | 13,076 B | 2,978 B | | MCU | 9,477 B | 5,709 B | 3,445 B | | Protocol | 25,733 B | 21,996 B | 19,160 B | | Calls | 14,411 B | 10,384 B | 5,008 B |
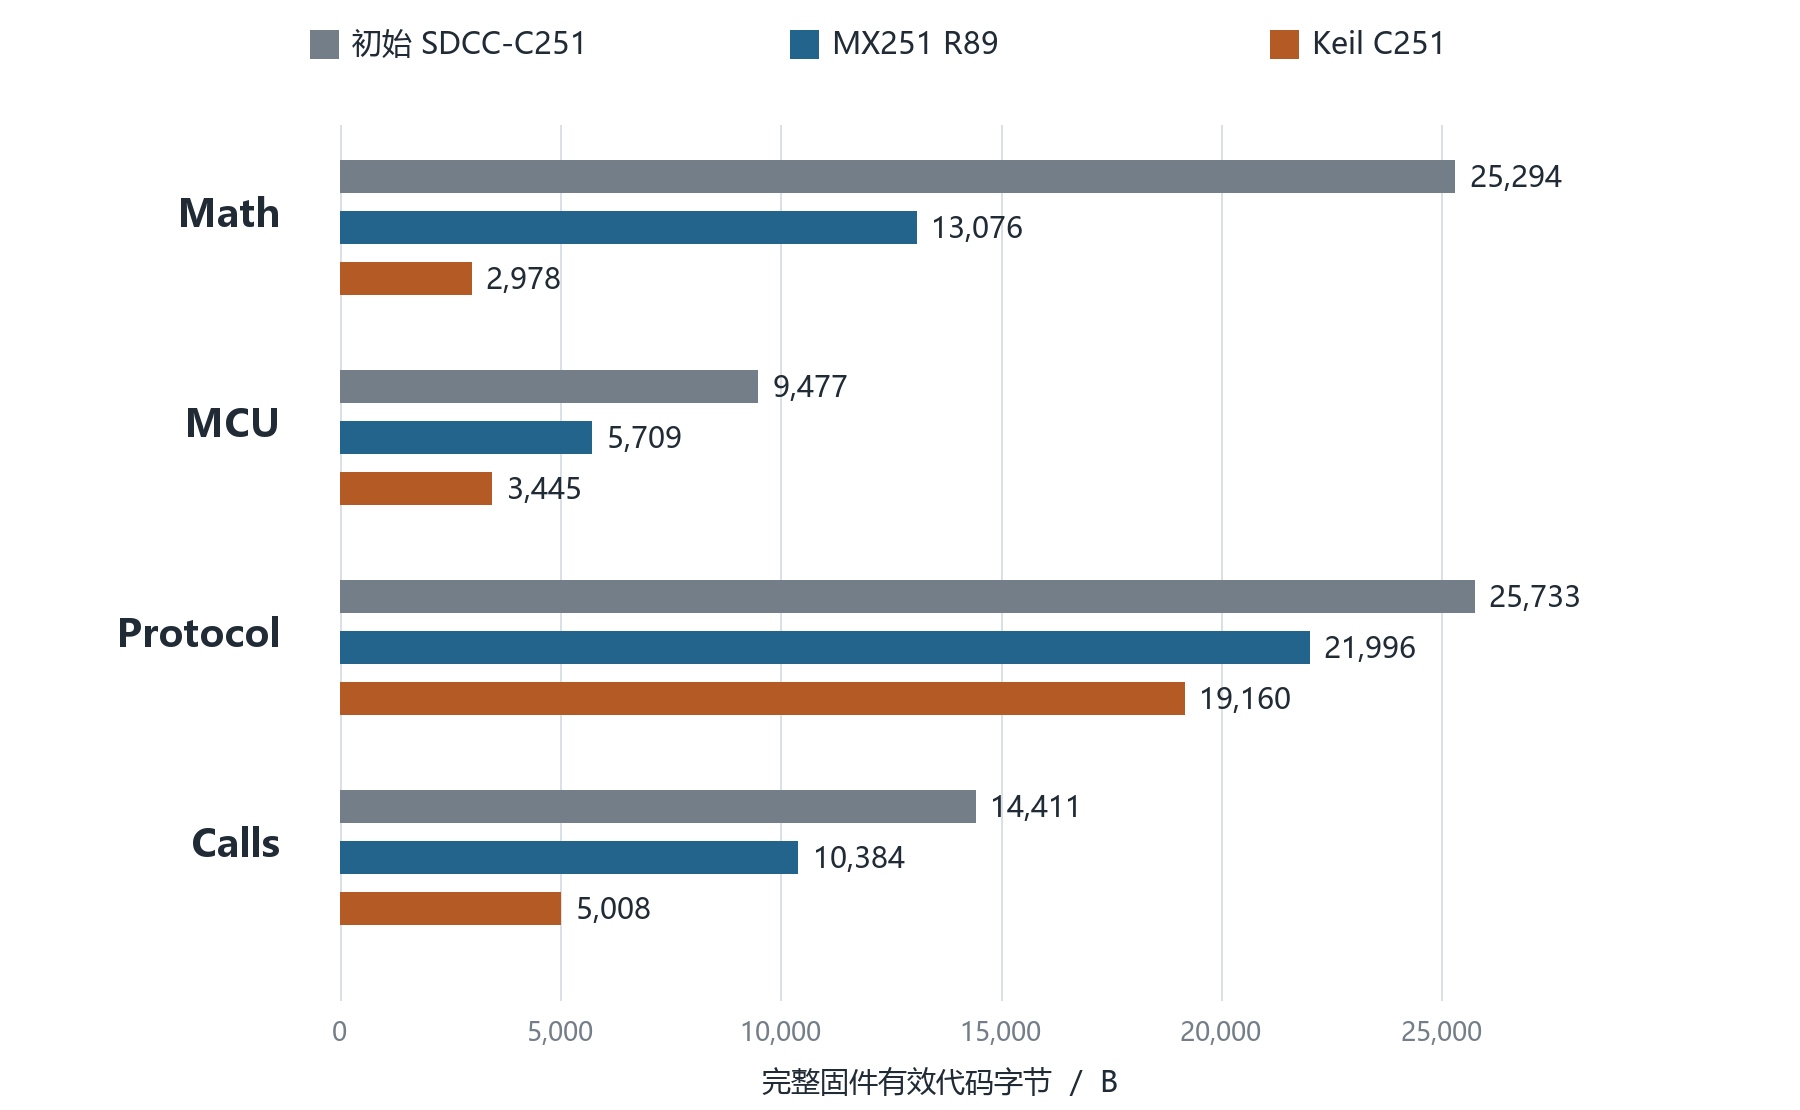
图2:同板对照归档中的完整固件有效代码体积,单位 B,越小越好。
R89 相对固定初始基线缩小了 14.52%~48.30%,但这四项在当时都还没有进入 Keil 体积的 110% 范围。相对旧版进步明显,与达到当前工程门槛,是两件需要分别证明的事情。
R30 的 8 个整数叶函数体积合计由 617 B 降到 316 B;32 个输入点的耗时比几何均值相对 R29 下降约 36.25%,与 Keil 的对应几何均值基本接近。不过最差单输入仍有约 2.64% 的退步,完整 Math 镜像也仅从 18,456 B 降到 18,410 B。叶函数优化的百分比,不能直接当作完整固件的收益。
V0.0110 的收益归因也有启发:软件数学路径由 18,000 B 降到 17,233 B,而对照编译的 64 个运行库成员逐字节相同。这一轮主要收益来自匹配运行库的刷新,不能全部归给新加入的编译器分析。
三、实板反例:代码更小,为什么反而更慢?
下面各行都是候选与其对应父版的配对结果,不能跨行拼成一条连续性能曲线。
| 候选/被测函数 | 函数体积 | 时间 | 观察 | | V0.0133/struct_records | 442→420 B | 2963→3002 tick | 更小但更慢 | | V0.0135/frame_parser | 317→299 B | 1299→1287 tick | 体积、时间同降 | | V0.0136/struct_records | 442→408 B | 2963→3030 tick | 永久保留的负例 | | V0.0139/struct_records | 442→412 B | 2963→2866 tick | 体积、时间同降 |
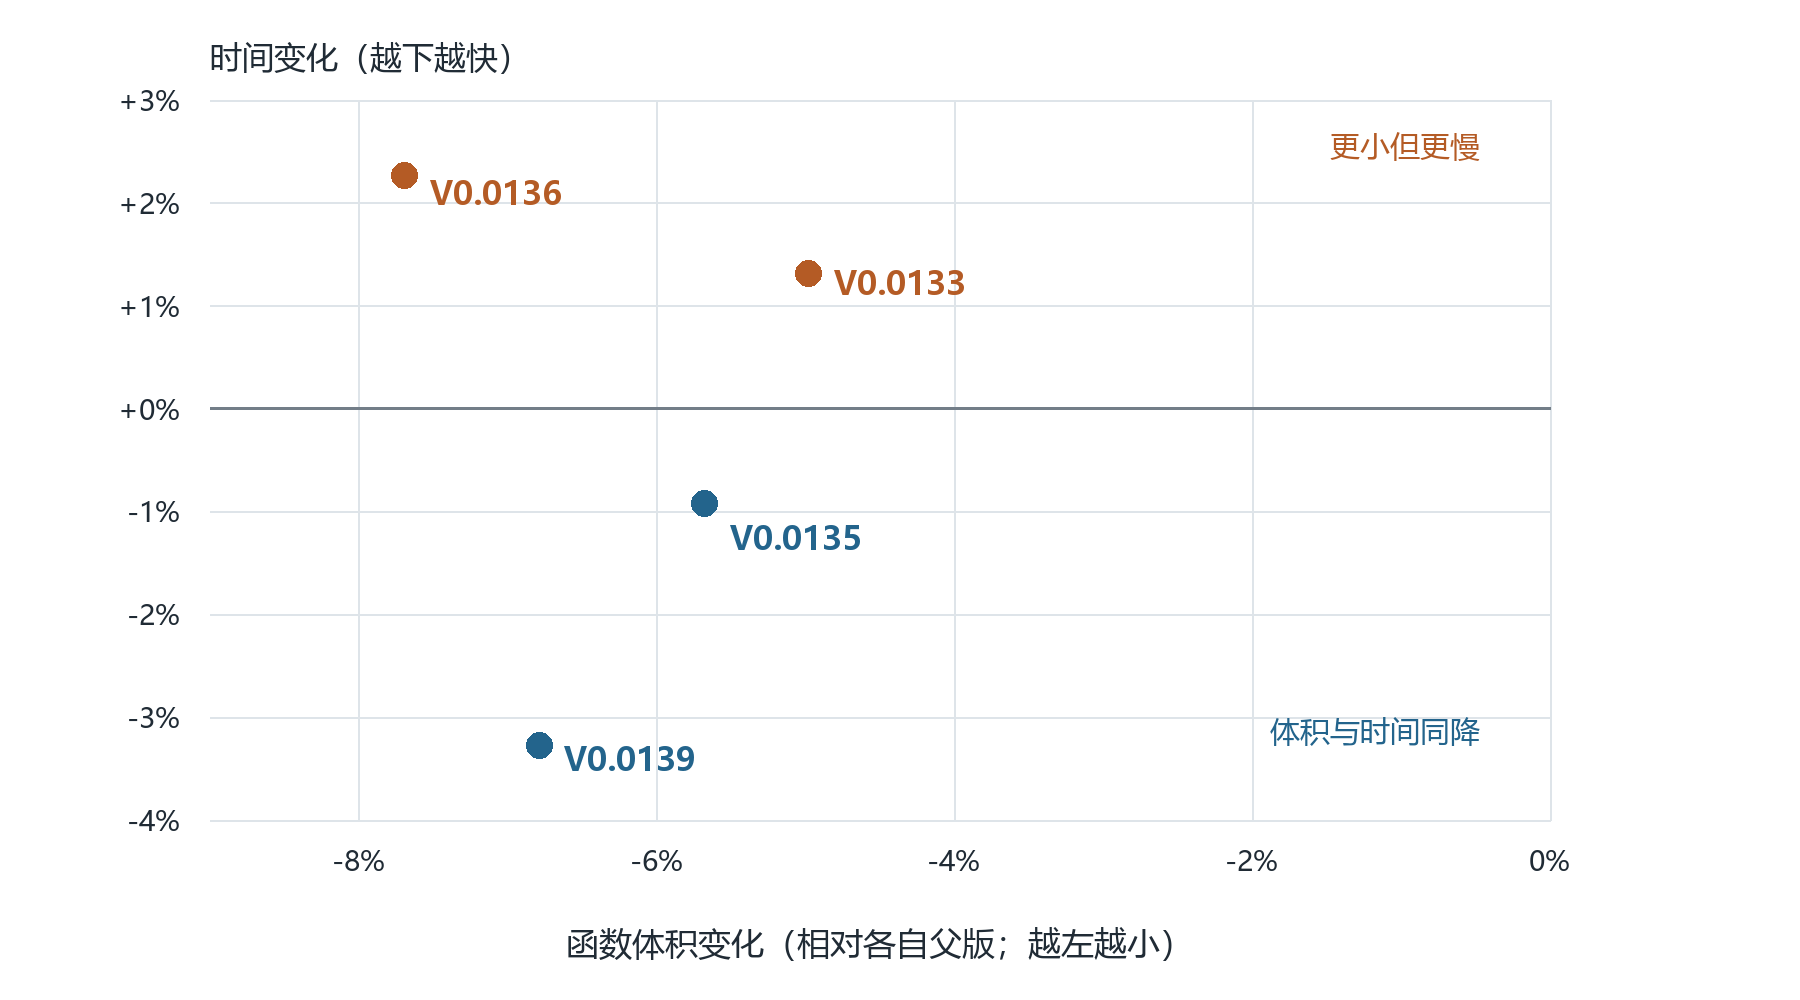
图3:相对各自父版的变化。向左表示体积减少,向下表示耗时减少。不同点对应的候选和配对基线不同。
V0.0136 的体积减少 7.69%,实测时间却增加 2.26%。旧模型估计成本从 668 降到 639,因此错误接受了候选;复查发现循环内增加了 64 次 MOV,循环外只减少了 28 次。这个例子让成本模型从静态计数进一步转向实际执行路径。
V0.0139 则在合法条件下提前结束地址值的存活期,struct_records 的体积和时间同时下降;64 次调用复核也由 23,707 tick 降到 22,933 tick,相应完整 MCU 镜像从 5619 B 缩到 5589 B。
另一类取舍出现在 V0.0155:区域共享让 Calls 镜像减少 591 B,但完整运行窗口在反馈 OFF 时从 4836 增到 5007 tick,在 ON 时从 4740 增到 4910 tick,约慢 3.5%。这轮只能说明相对父版的体积/时间取舍,不能借用另一轮 Keil 数据宣称达标。最终机器码核查还曾截获 MOVH 高半重定位错误,说明只看汇编文本仍不够。
四、已经取得的完整 Calls 工程实板结果
目前采用的性能门槛是:同一固定完整工程,在统一功能、输入域和计量条件下,体积和运行时间都不超过同目标 Keil C251 对照的 110%,同时满足正确性要求。工程可用性仍要另有证据,不能用平均值掩盖某个工程超标。
下表来自后续已归档的固定 Calls 工程快照,每行的体积与时间属于同一个受测配置。ON/OFF 是叶函数调用反馈开关。
| 目标/配置 | MX251 | 同目标 Keil | 体积比/时间比 | | AI8051U 反馈 ON | 5356 B/5221 tick | 5008 B/5069 tick | 106.95%/103.00% | | AI8051U 反馈 OFF | 5231 B/5402 tick | 5008 B/5069 tick | 104.45%/106.57% | | STC32G CFG 收敛候选 | 7203 B/5534 tick | 6558 B/5069 tick | 109.84%/109.17% |
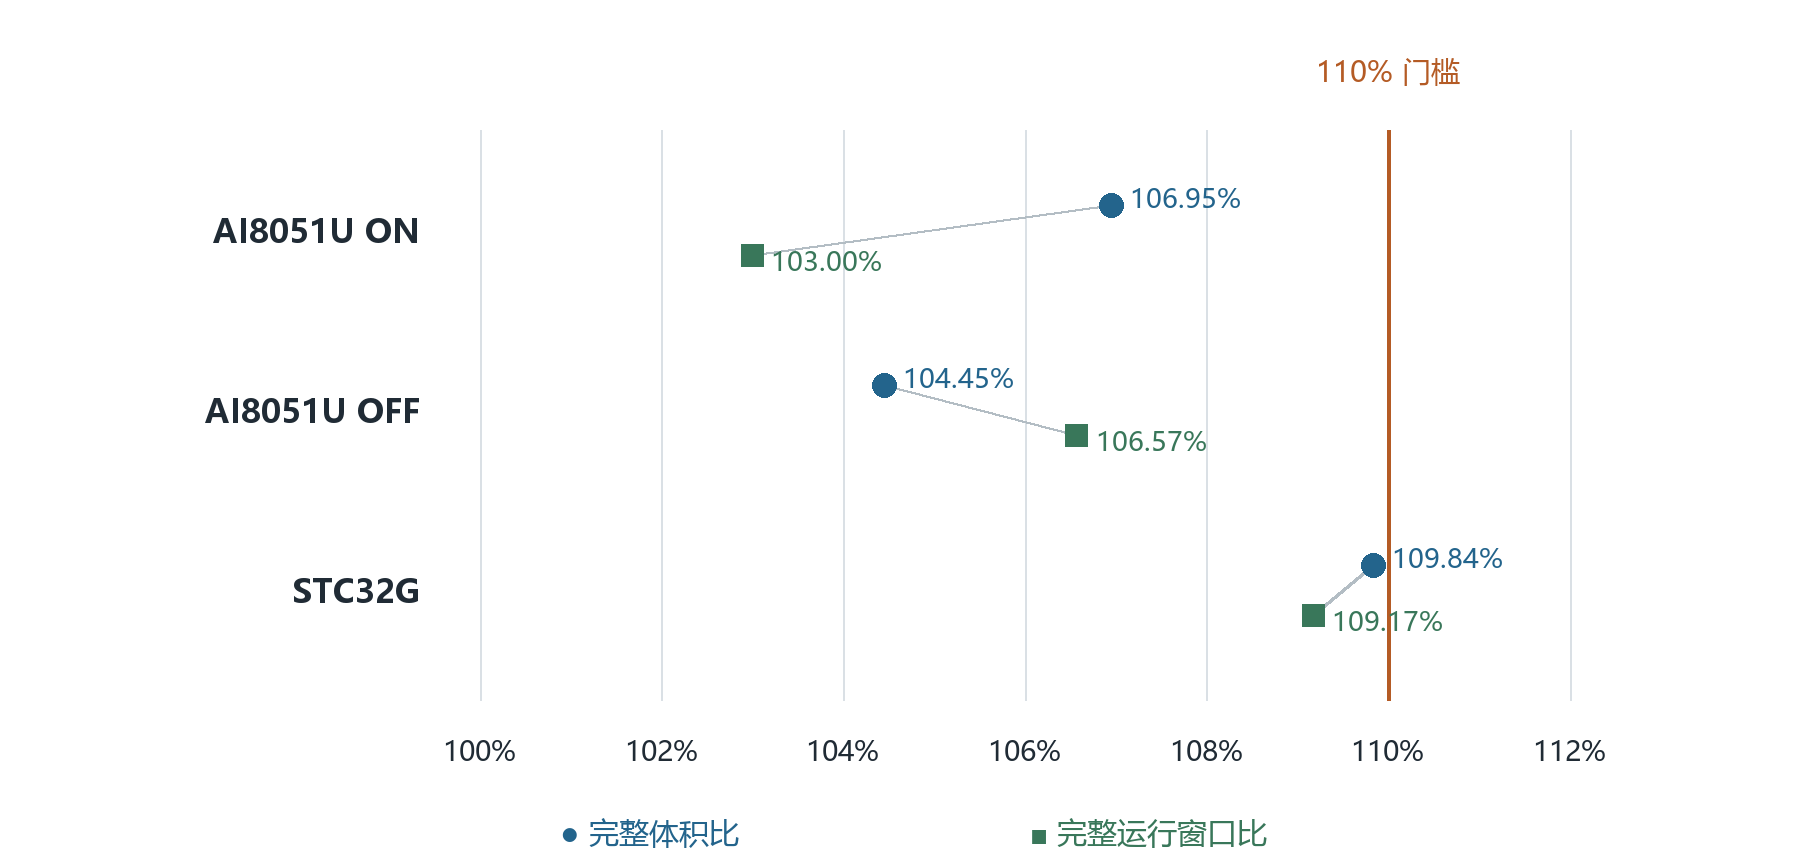
图4:上述固定 Calls 工程的体积比与完整运行窗口时间比,以各自 Keil 对照为 100%。
AI8051U 两个配置分别有 3 次独立启动记录,STC32G 该候选有 2 次。STC32G 对应整数门槛为 ≤7213 B、≤5575 tick,当前余量只有 10 B 和 41 tick,后续改动仍须重新确认。
这些结果支持“特定固定完整工程已进入双 110% 范围”。它们不意味着任意工程都已达标,也不能从 AI8051U 的结果推导其他器件已经通过。表内 tick 仅用于对应归档窗口的成对比较;跨板、跨夹具、跨分频的绝对 tick 不能直接互比。
五、仍未完成的部分,也一并公开
1)SDK 动态时间仍有缺口。在本文固定的 SDK 状态快照中,Timer API 热态窗口为 377/334 个采样点,即 Keil 的 112.87%;PWM 更新为 95/79,即 120.25%,初始化和启动窗口也仍超标。这里是 24 MHz 逻辑分析仪采样点,不是 CPU 周期,也不是完整 main 的运行时间。UART1 的三个配置已有较好的窗口结果,但不能据此宣布整个 SDK 动态资格完成。
2)高压力工程仍有明显差距。默认路径为 6915 B/5140 tick,对照 Keil 为 4220 B/3697 tick。显式开启普通 DATA 宽访问后的独立配置可降到 6285 B/4859 tick,仍是 Keil 的 148.93%/131.43%,没有达到双门槛。该开关默认关闭;它改变字节间可中断边界,不能当成 MMIO/SFR、C 原子访问或共享对象中断安全已经合格的证据。
3)体积合格不等于完整工程合格。例如 V0.0146 的 Protocol 完整体积曾进入 110% 范围,但该结论仅限体积。回调、中断、函数指针、未知调用、最新镜像和 SDK 配置组合,仍需分别补齐覆盖;历史异常与失败记录也要保留。
4)当前仍是内部优化与验证阶段。编号候选和主题快照不等于已统一发布的稳定版本,尚不能给整个工具链授予全面达到 Keil C251 水平或长期支持版本的结论。本文数据来自项目内部实验档案,尚无外部独立复现。
六、接下来希望解决什么?
接下来会继续围绕通用 MCS251 能力推进:完善宽后端与地址/调用语义,补齐 Timer/PWM 及高压力场景的时间缺口,加强最差输入、ISR 与函数指针闭包验证,并保留永久成本模型负例。
MX251 的目标是让完整工程获得可复核的收益,并保留独立工具链入口。当前先分享架构和实板细节;后续源码、运行库与 SDK 的公开范围及可复现材料,会在满足相应准备条件后另行说明。现阶段不承诺正式发布时间。
欢迎大家针对宽寄存器利用、ABI 设计、成本模型、测试覆盖和工程可复现性提出意见。尤其欢迎指出可能遗漏的调用、地址空间与中断边界问题。
项目与资料
MCU StudioX:GitHub 项目主页
SDCC-C251 上游:gevico/sdcc-c251
SDCC 文档:SDCC Compiler User Guide
实验来源:项目内部的 R89 同板对照、R30 清洁发布测试、V0.0110 归因、V0.0133/0135/0136/0139 配对测试、V0.0155 完整驱动计时、2026-10-30 Calls/CFG 快照及 2026-10-31 SDK 状态记录。完整原始档案暂未公开;本文图表是归档数据的整理,不是外部独立测评。
|
1
喜欢他/她就送朵鲜花吧,赠人玫瑰,手有余香!
-
 +2 楼主威武~
|
 |手机版|深圳国芯人工智能有限公司
( 粤ICP备2022108929号-2 )


 已绑定手机
 发表于