|
以下内容【何宾老师及其团队】将整理发布在待发售新书中,敬请期待。
离线语音识别控制系统 · 实现流程
Ai8051U 单片机端侧 AI · 语音采集 → MFCC → CNN → LED 控制(第18章)
1. 项目概览
| 硬件平台 | 输入设备 | 输出设备 | 识别指令 | 特征/模型 | 单次处理耗时 | | Ai8051U 开发板 | 板载 MIC(ADC 通道 P1.2) | LED0~7(P0.0~P0.7) | "开灯"/"关灯"/"无效指令" | MFCC 32×32 + 轻量 CNN(约 880 参数) | MFCC 1681ms + CNN 901ms |
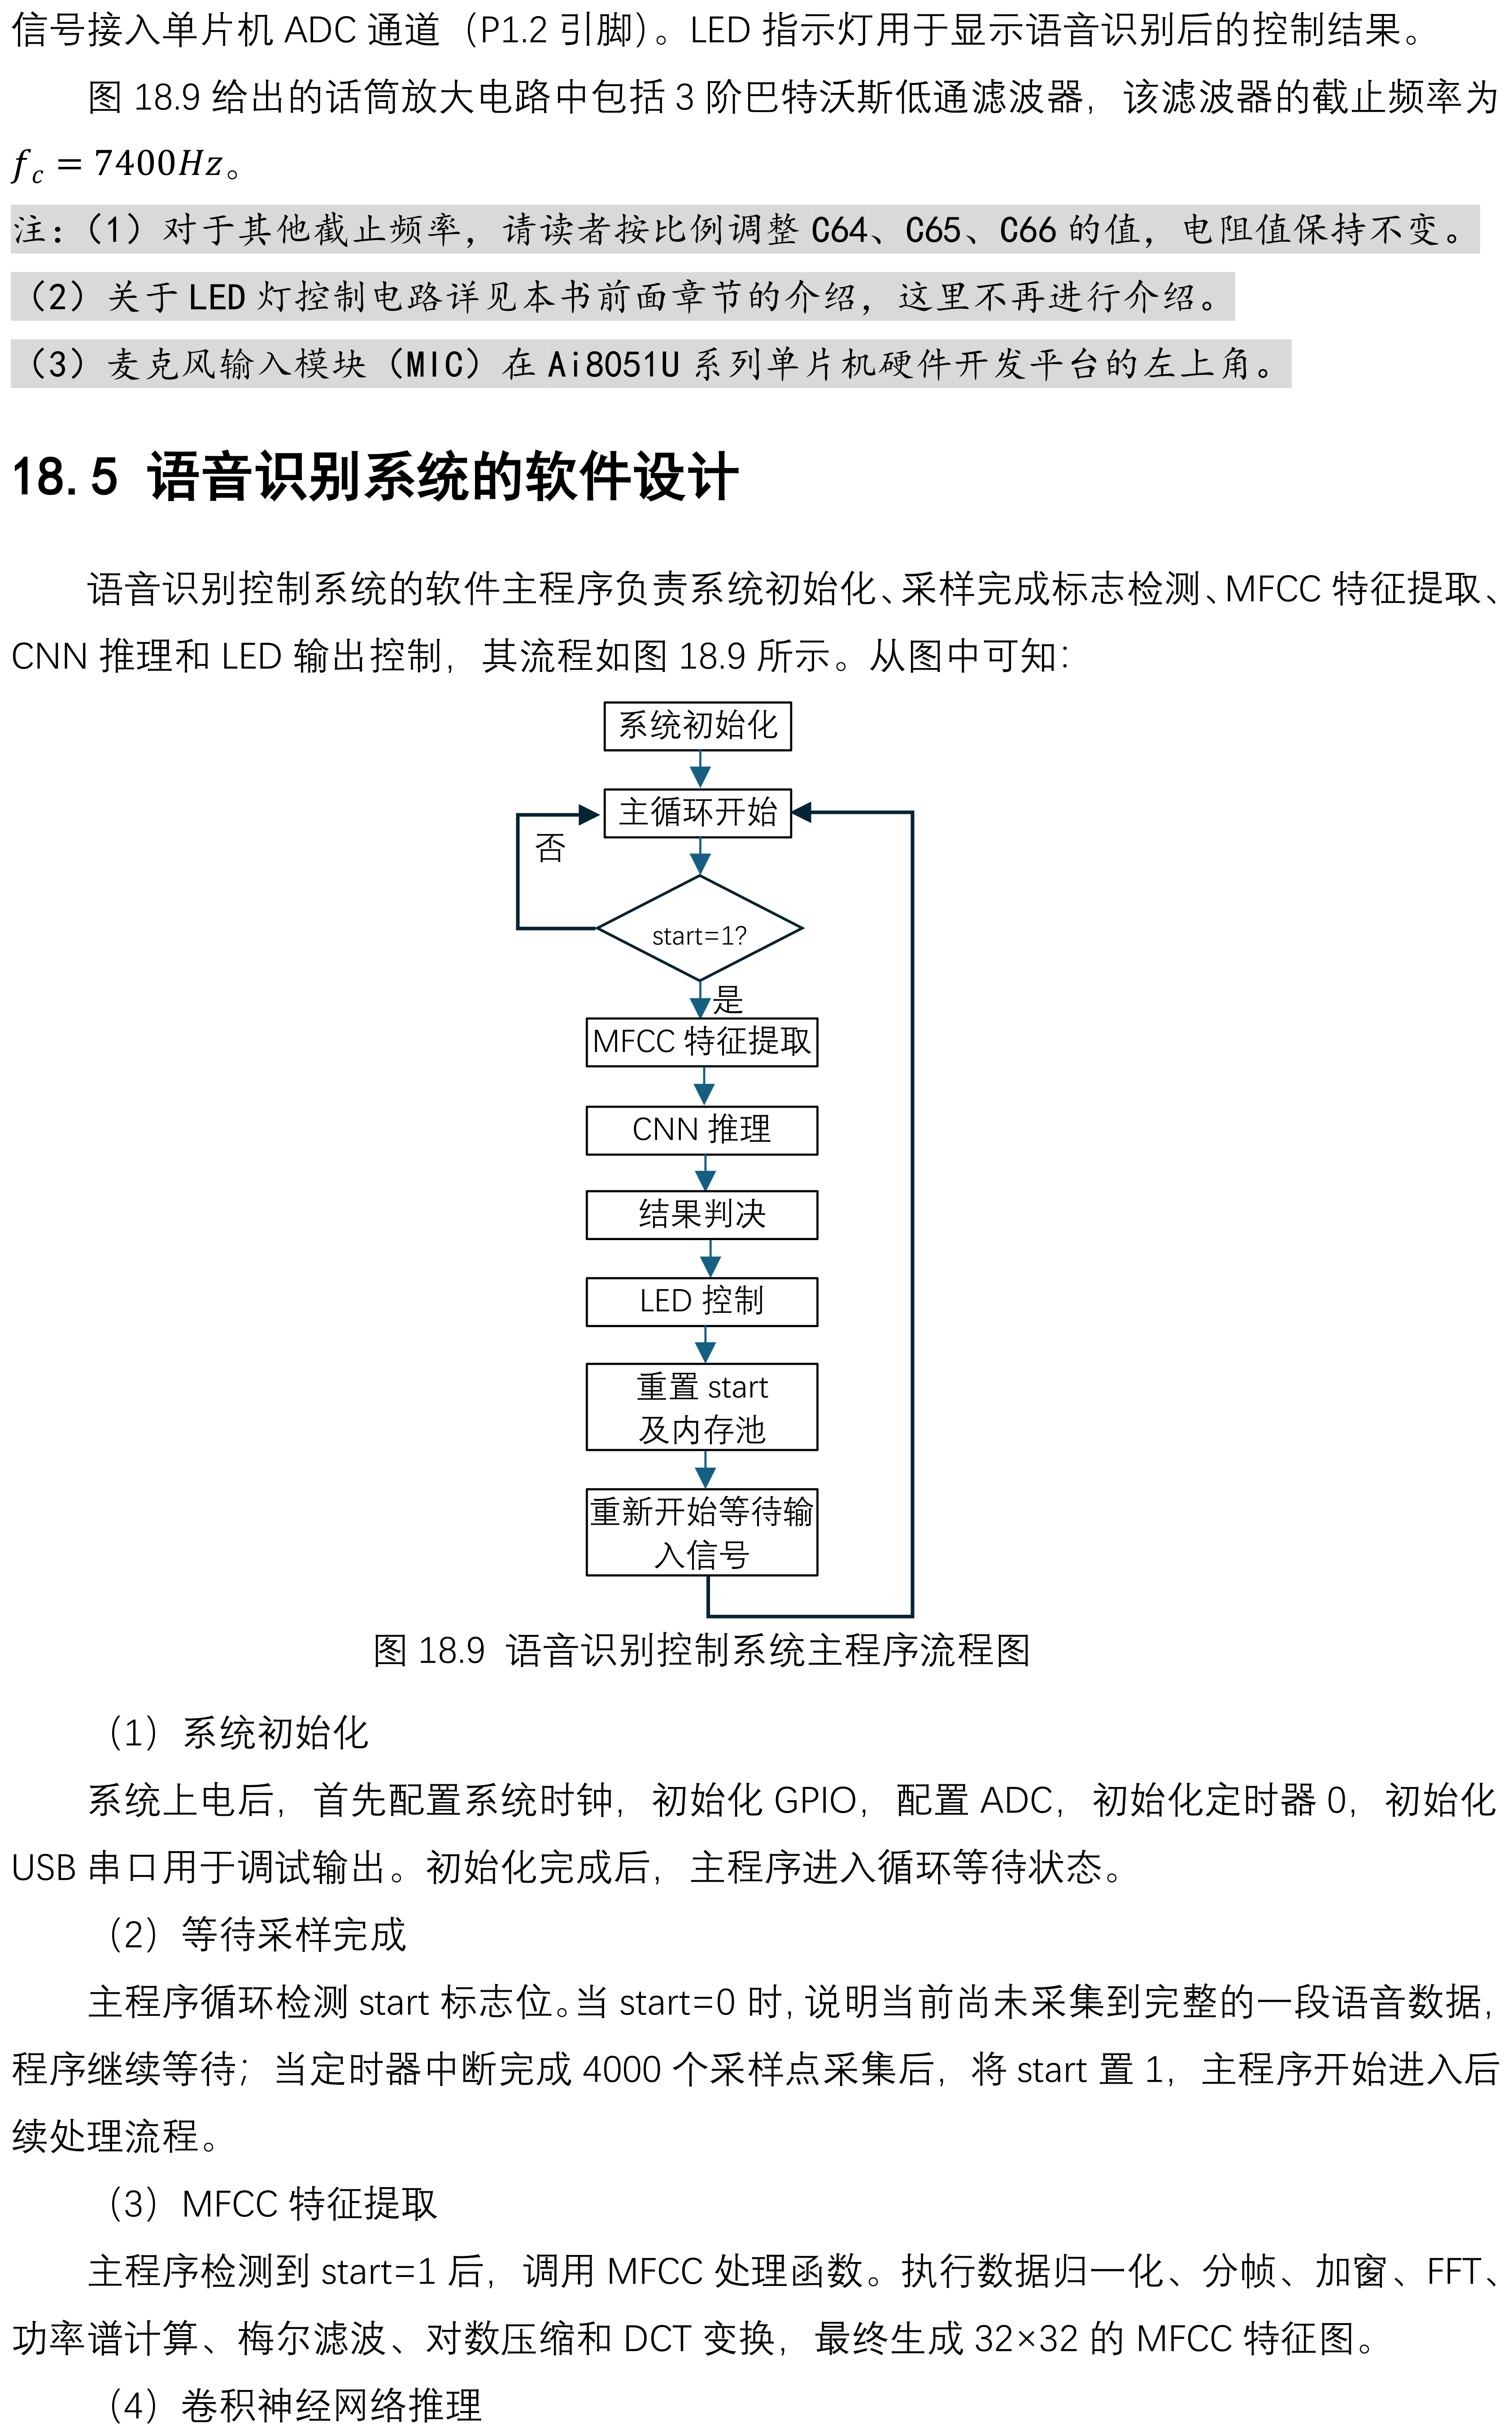
数据流:ADC 采样 4kHz/1s → MFCC 特征提取 (32×32) → CNN 推理 (3 类置信度) → 结果判决 → LED 亮/灭控制
2. 模型训练(PC 端)
2.1 数据采集:训练样本直接用单片机开发板采集的原始 ADC 数据(采样率/量化位数/麦克风特性与实际推理一致,消除数据源偏移),经串口发 PC 保存;每样本 4000 个采样点 = 1s;每类 500 个样本(训练 400 + 测试 100);无效指令含环境噪声、非指令语等增强鲁棒性。
2.2 MFCC 参数:
| 参数 | 值 | 参数 | 值 | | 采样率 | 4000 Hz | 帧数 | 32 | | 采样点数 | 4000 | FFT 点数 | 32(保留前 18 个频点) | | 帧长 | 32 | 梅尔滤波器数 | 32 | | 帧移 | 128(帧移 > 帧长,间隔分帧省算力) | 输出特征 | 32×32 |
流程:峰值归一化(零偏校正+幅值缩放+峰值归一化到 [-1,1])→ 分帧加汉明窗 → 32 点 FFT → 功率谱 → 梅尔滤波(32×18 矩阵乘)→ 对数压缩 dB=10·log10(P),80dB 动态裁剪 → DCT(32×32)→ 幅值补偿 + 行正交归一化。
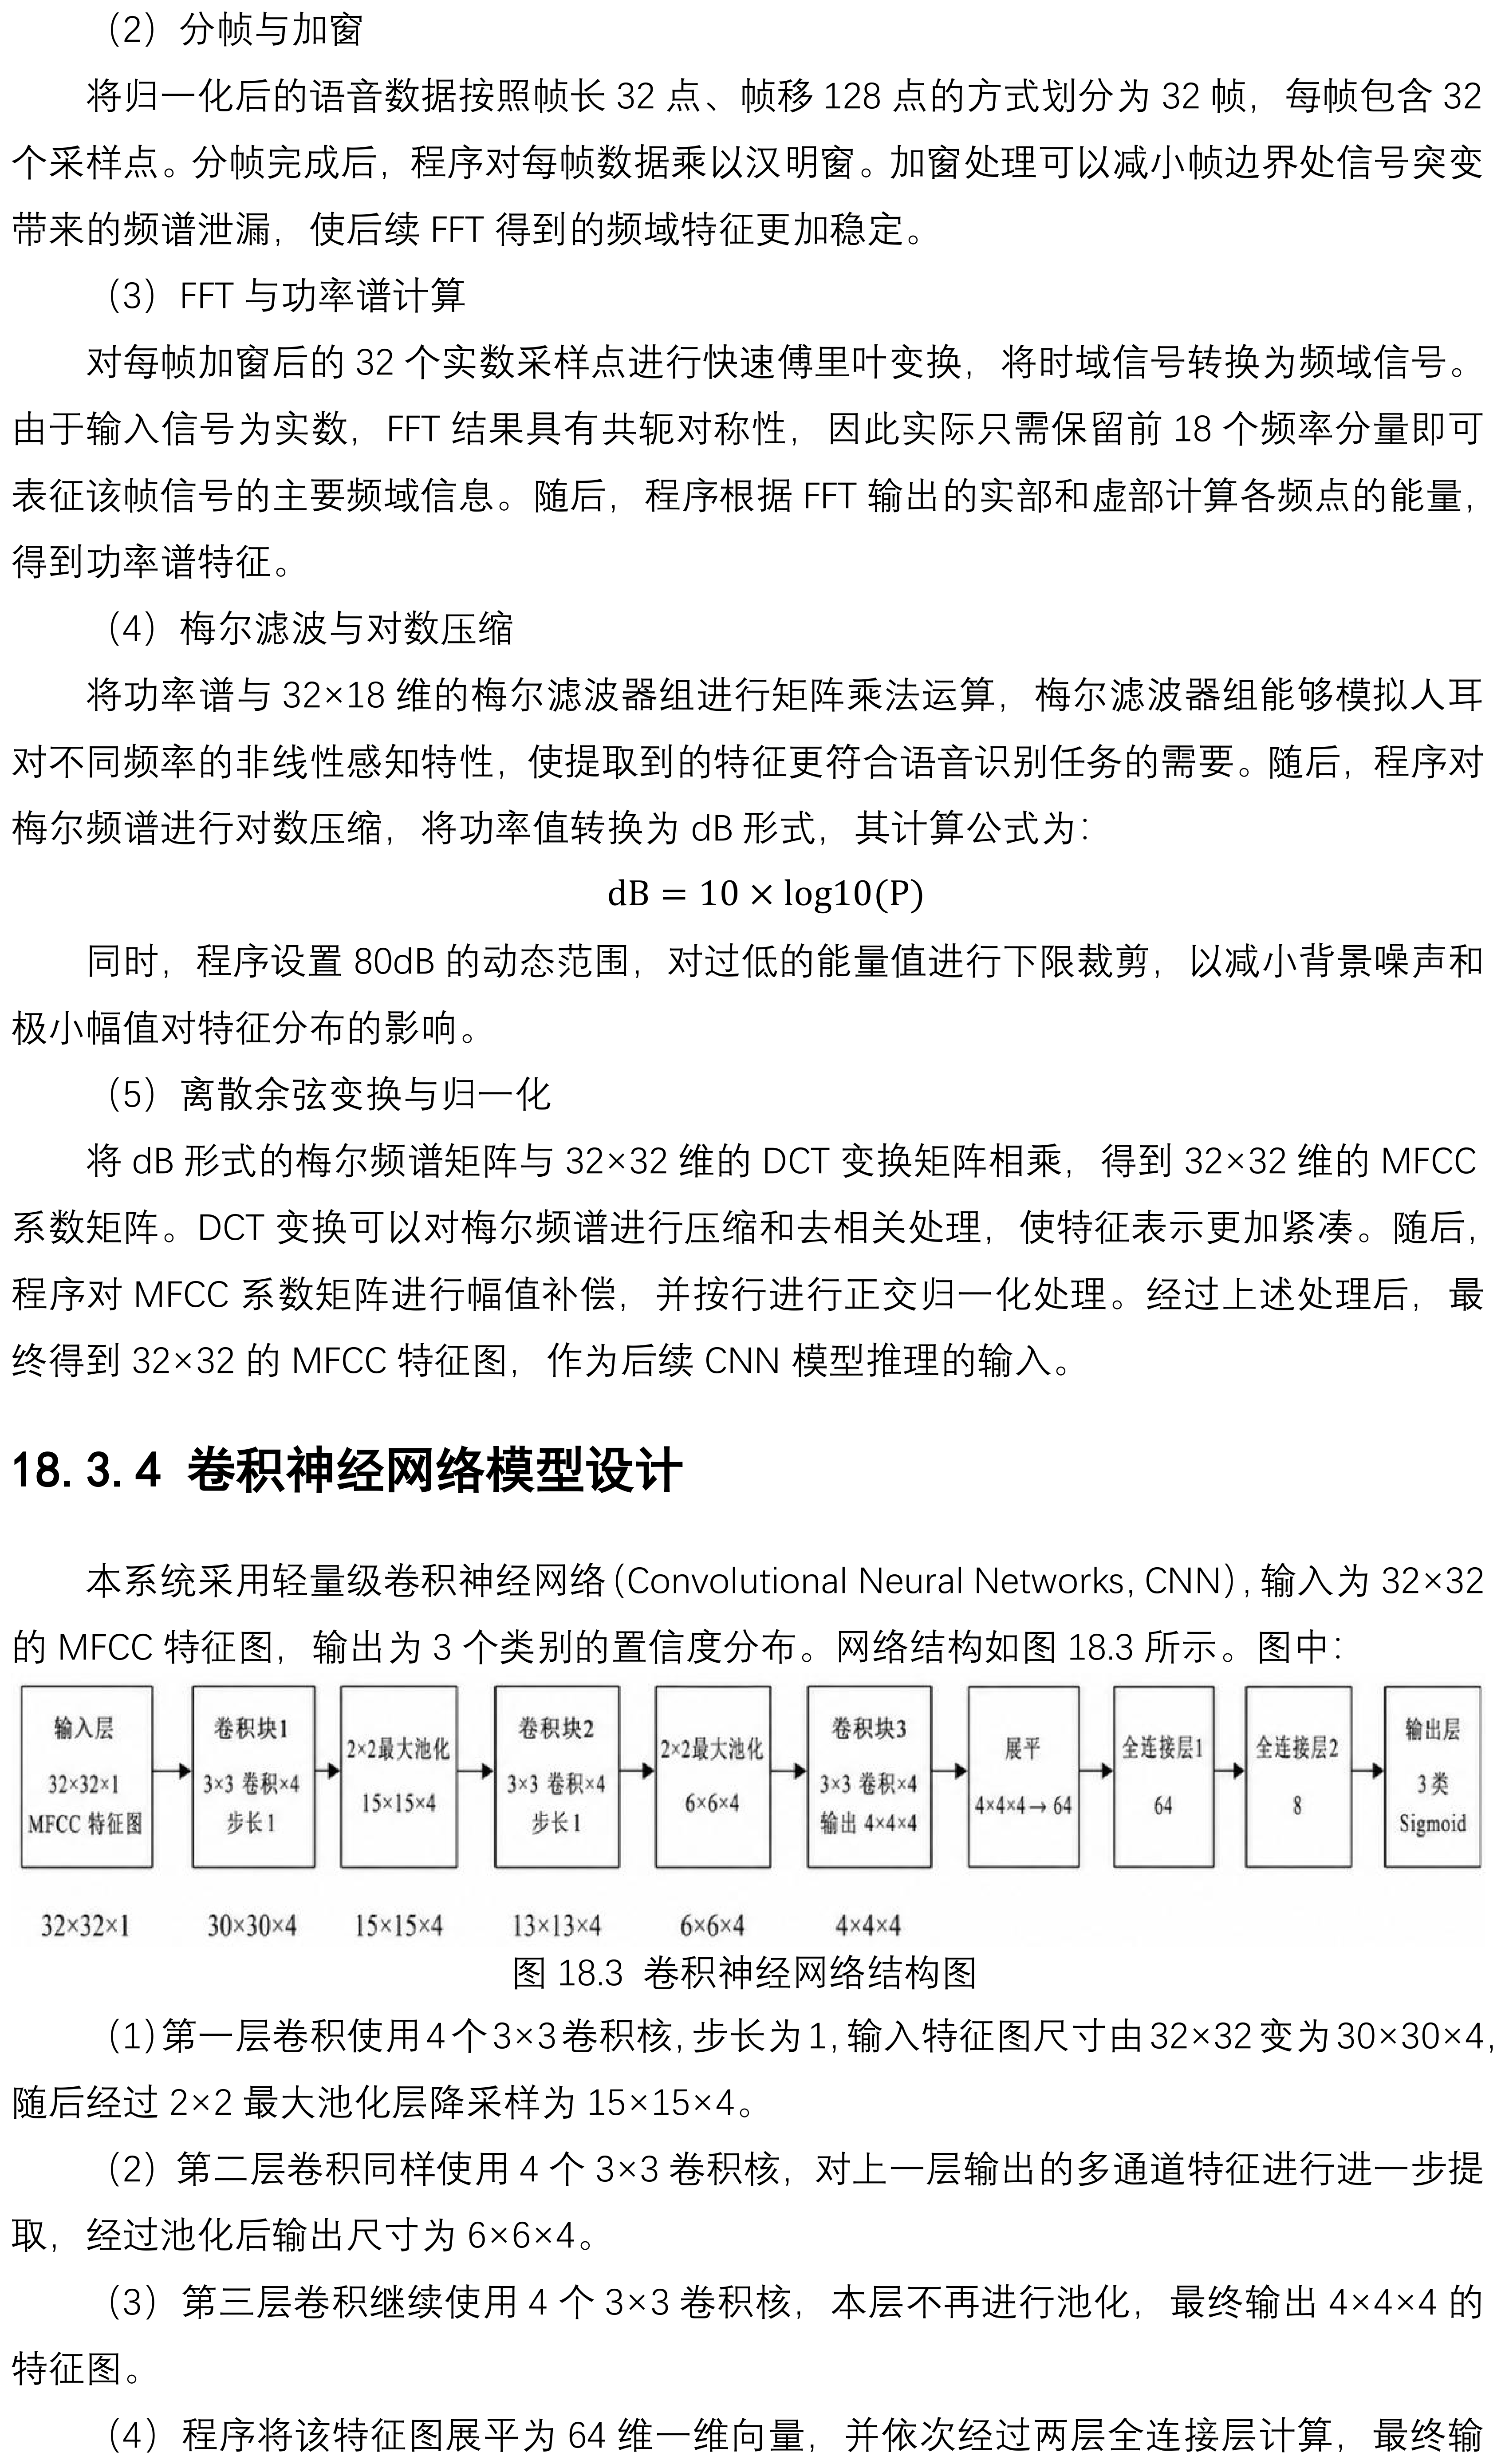
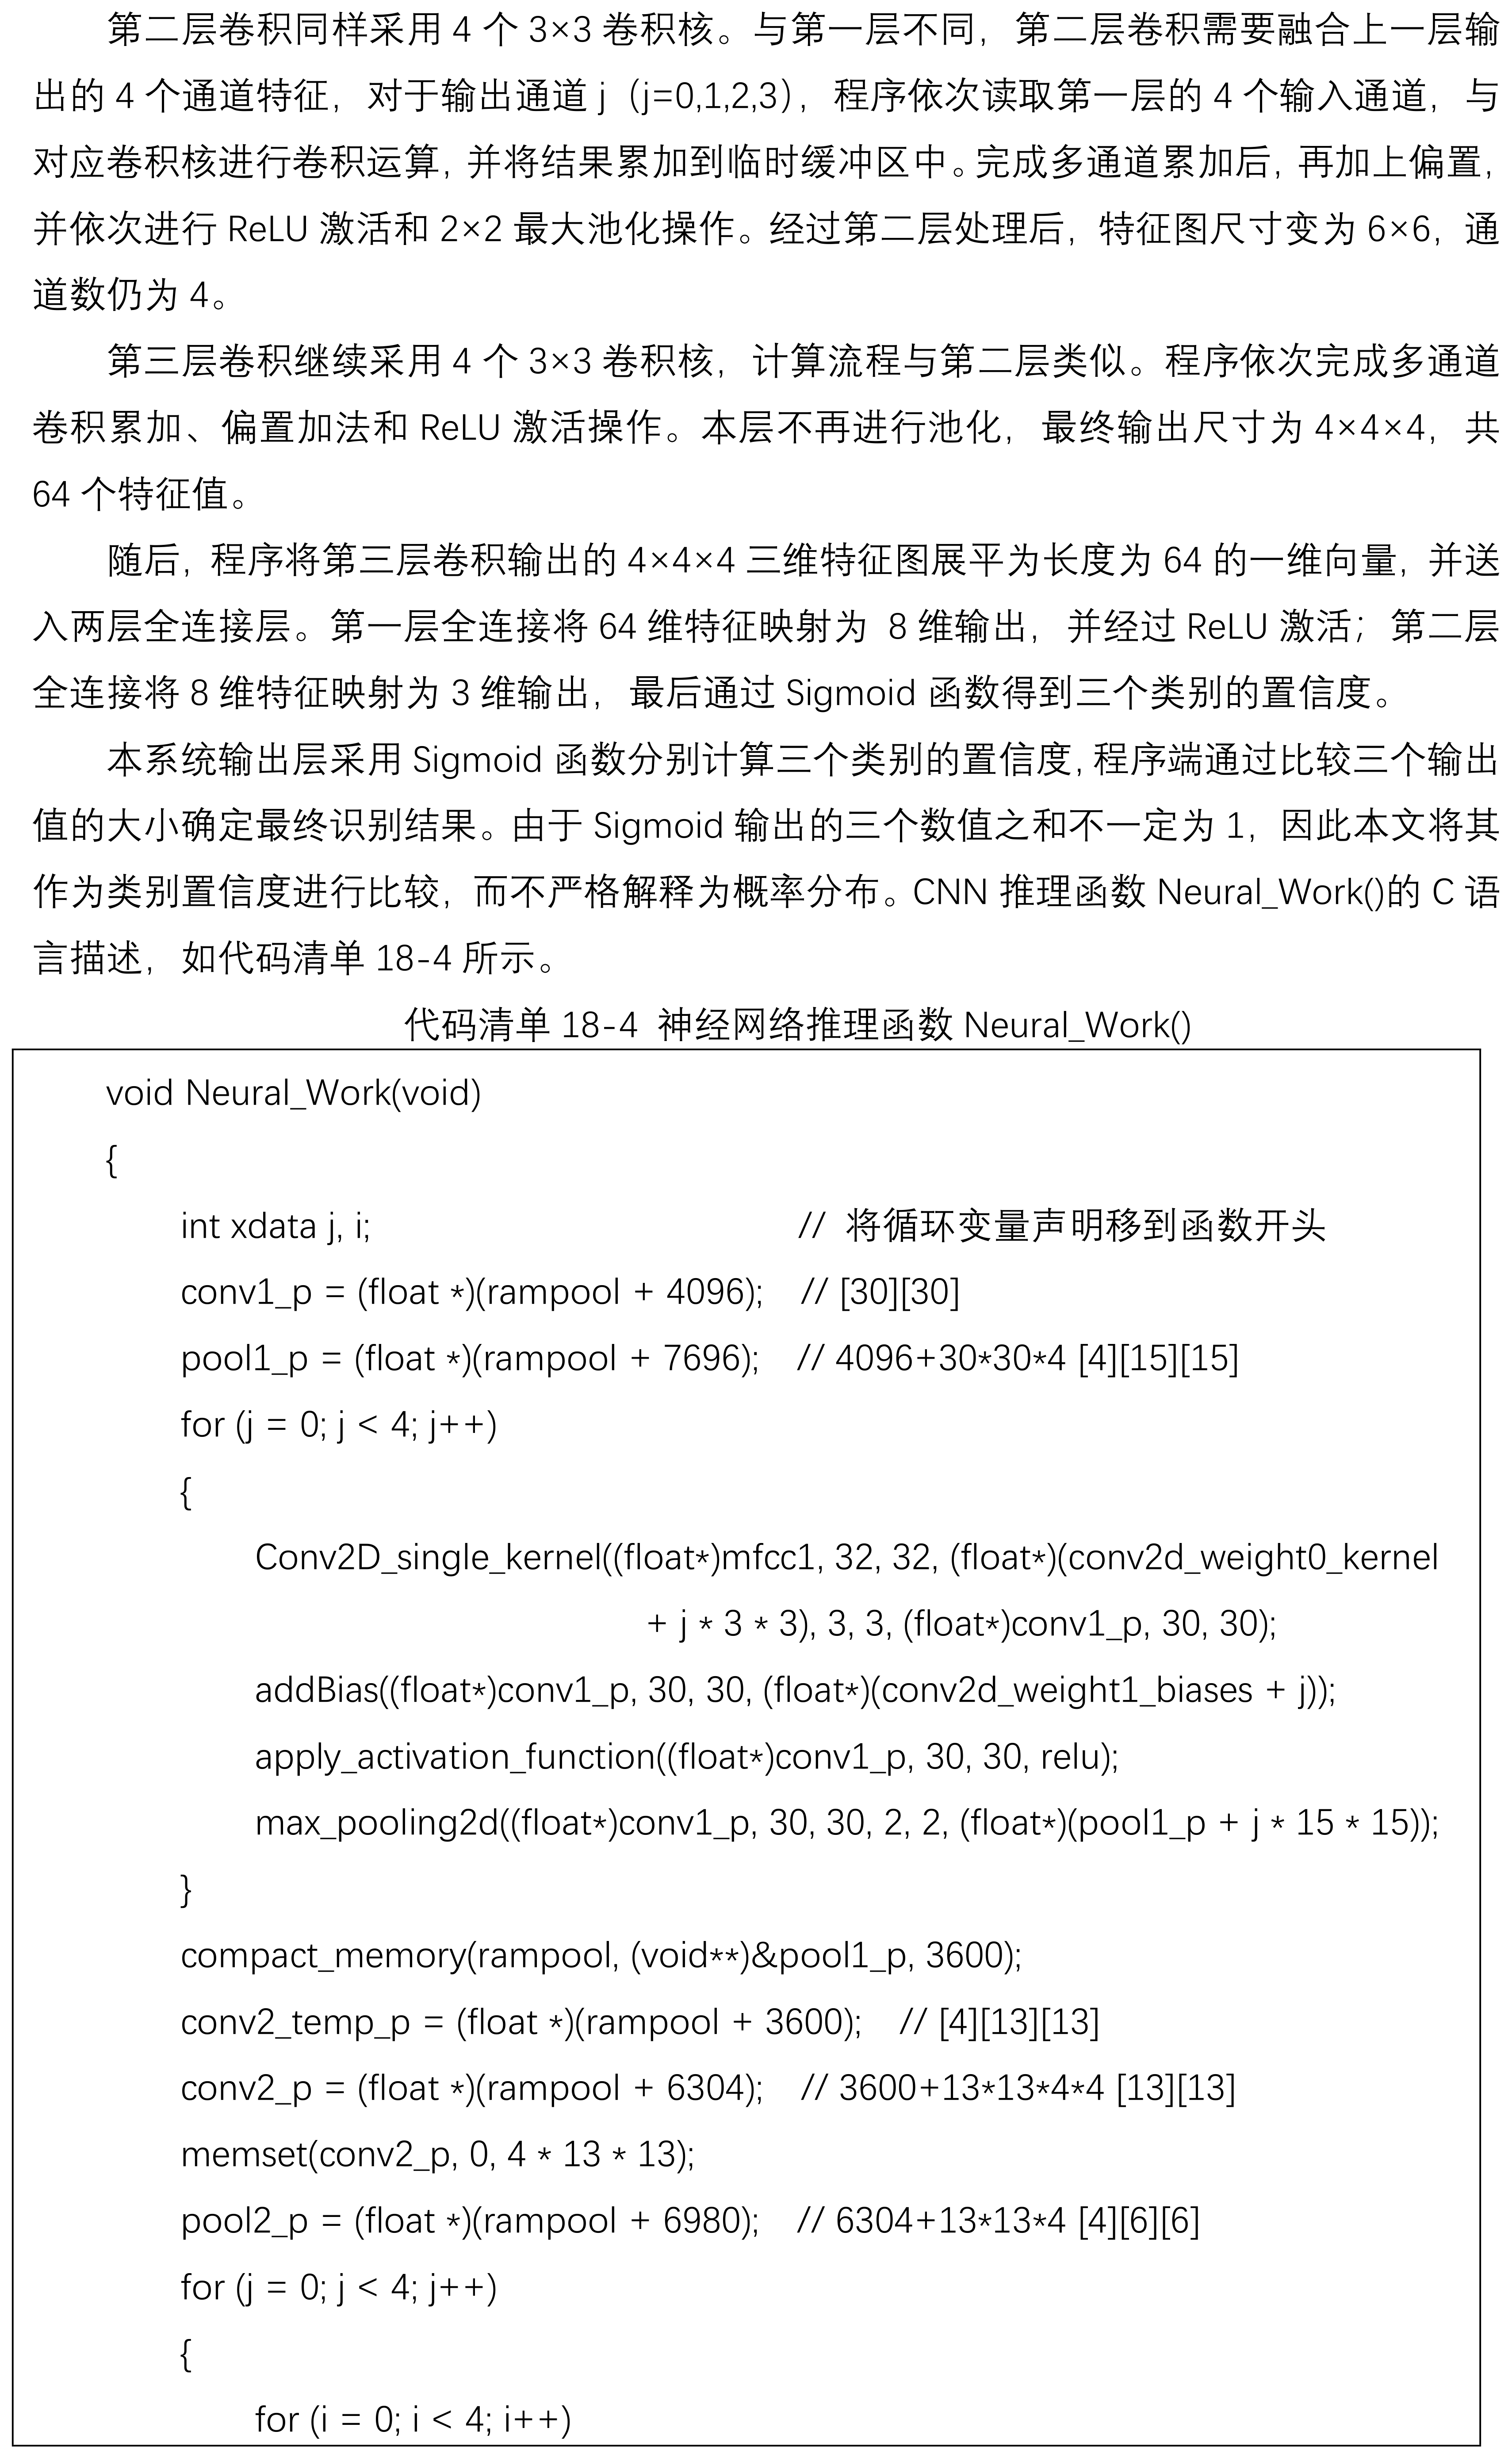
2.3 网络结构:32×32 输入 → Conv1 4×(3×3) → 2×2 Pool → 15×15×4 → Conv2 4×(3×3) → Pool → 6×6×4 → Conv3 4×(3×3) → 4×4×4 → Flatten 64 → FC 64→8 (ReLU) → FC 8→3 (Sigmoid)。隐藏层 ReLU,输出层 Sigmoid 得三个独立置信度,取最大值定结果,总参数约 880。
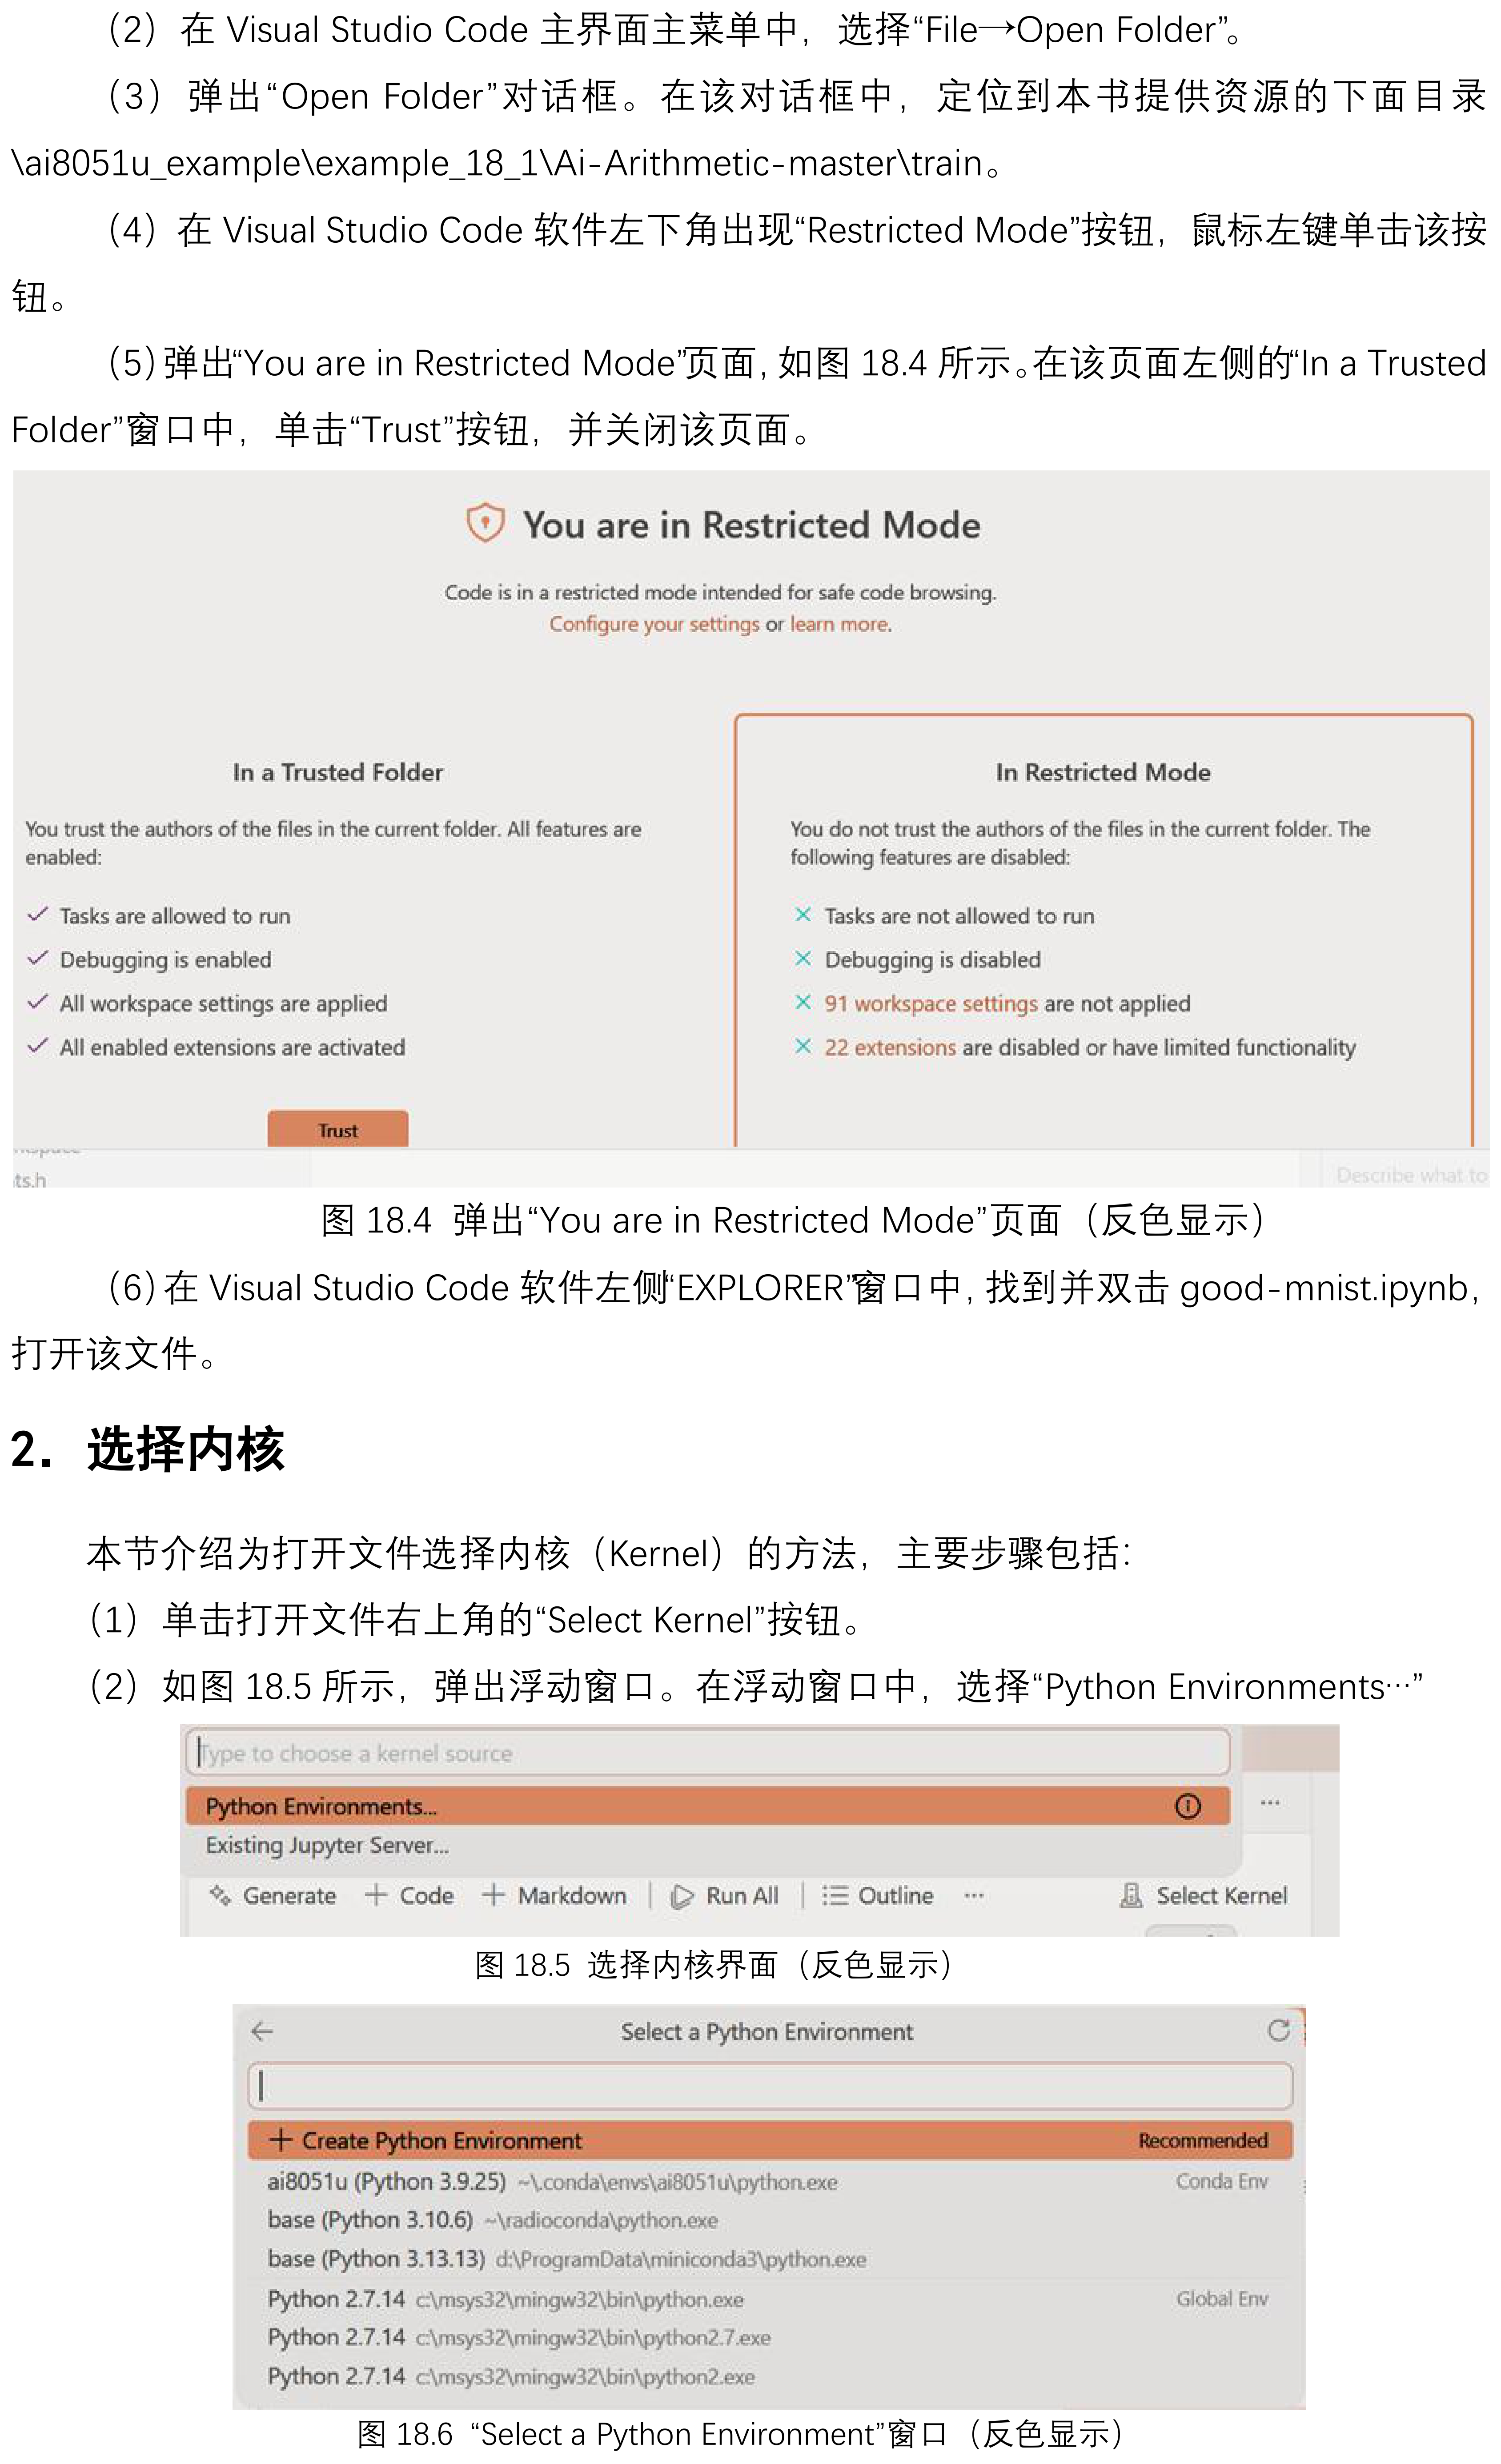
2.4 训练与运行:TensorFlow 2.14;Adam,lr=0.001,batch=32,最大 50 轮,早停耐心 10;损失分类交叉熵,按 8:2 划分训练/验证集。复用第 17 章 ai8051u Python 环境(Python 3.9),VS Code 打开 \ai8051u\_example\example_18_1\Ai-Arithmetic-master\train,选内核 ai8051u,打开 good-mnist.ipynb → 点 Run All,导出 best_model.h5 并转 C 语言数组。须保证 PC 与单片机端 MFCC 参数、归一化方式、数据排列、权重维度完全一致。
3. 单片机工程部署(Keil μVision C251)
打开工程 \ai8051u\_example\example_18_1\AI8051U-yuyin\yuyin.uvproj,模块划分:
| 文件 | 功能 | | main.c | 系统初始化、主循环、定时器中断、LED 控制 | | mfcc.c | 音频归一化、分帧、加窗、FFT、梅尔滤波、DCT | | conv2d.c | 卷积、池化、全连接、激活函数等 CNN 推理 | | data.c | 训练导出的模型权重、偏置和常量数据 | | memory_management.c | 内存池定义、内存整理与中间数据复用 |
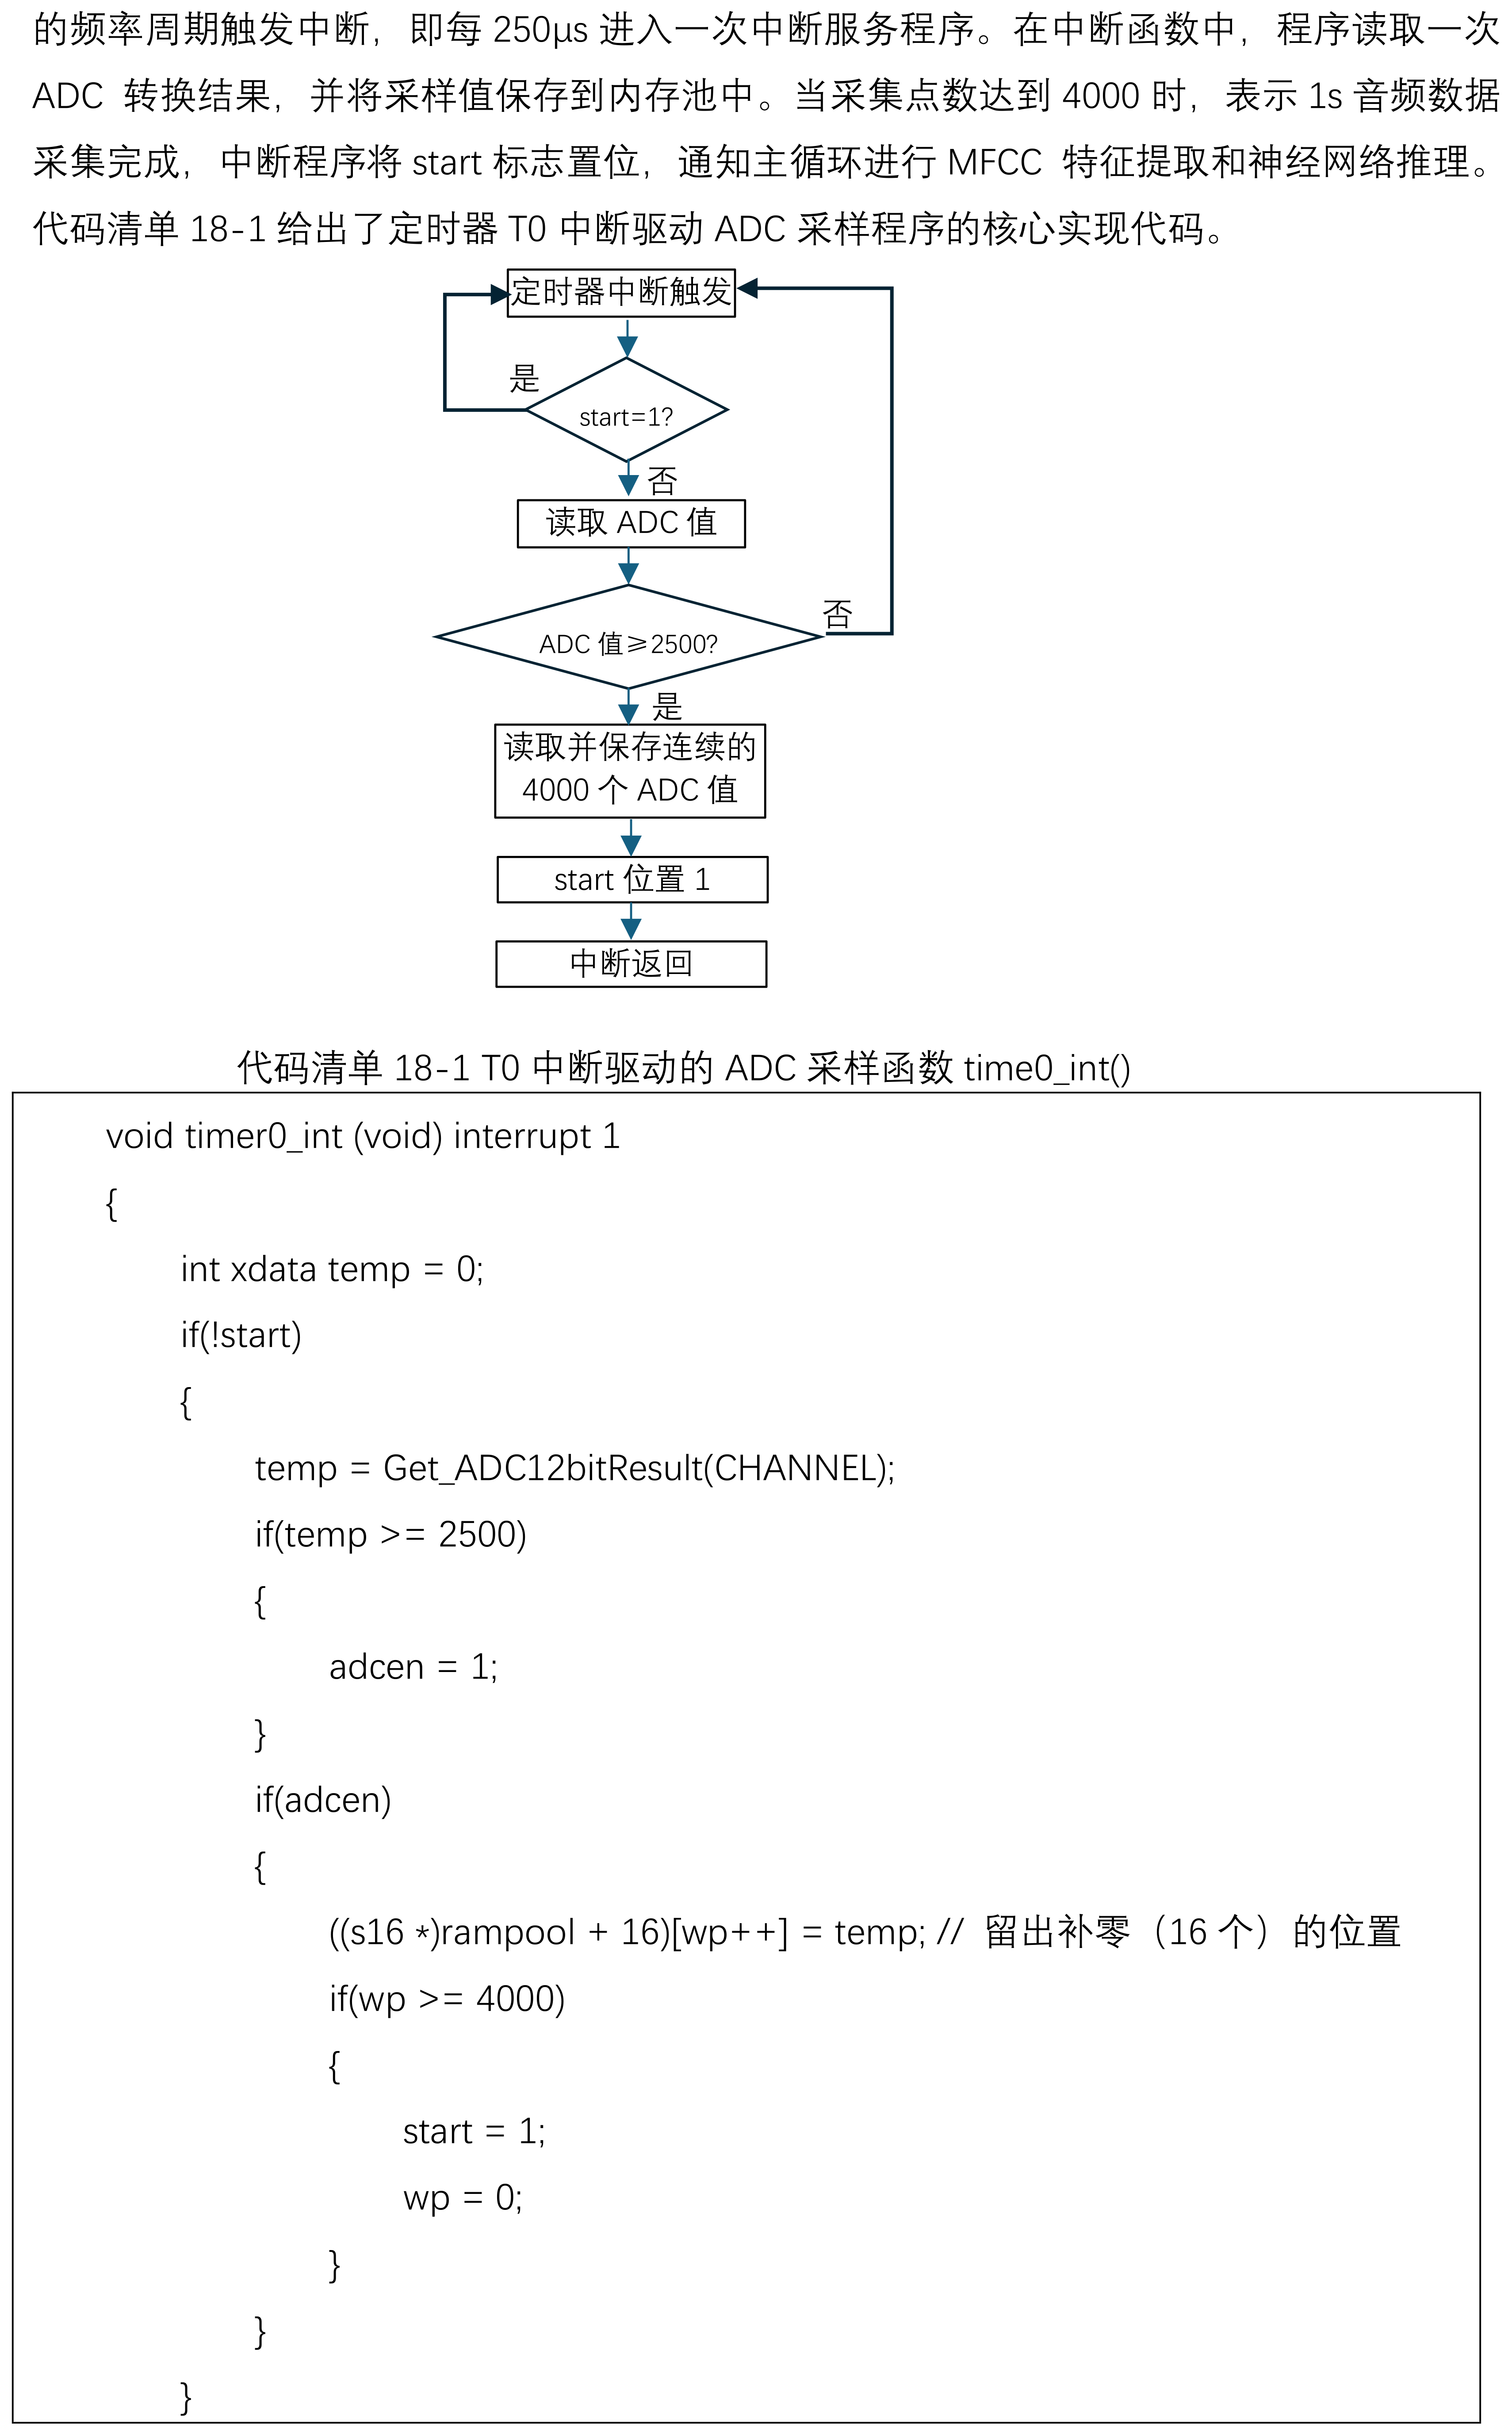
3.1 ADC 采样(定时器 T0 中断驱动):4kHz 周期触发(每 250μs 一次中断),读取一次 ADC;采样值 ≥ 阈值 2500 判定检测到语音,此后连续保存 4000 点,采满后置 start=1 通知主循环。
- void timer0_int(void) interrupt 1 {
- int xdata temp = 0;
- if(!start) {
- temp = Get_ADC12bitResult(CHANNEL);
- if(temp >= 2500) adcen = 1; // 语音检测阈值
- if(adcen) {
- ((s16 *)rampool + 16)[wp++] = temp; // 前留 16 个补零位
- if(wp >= 4000) { start = 1; wp = 0; }
- }
- }
- }
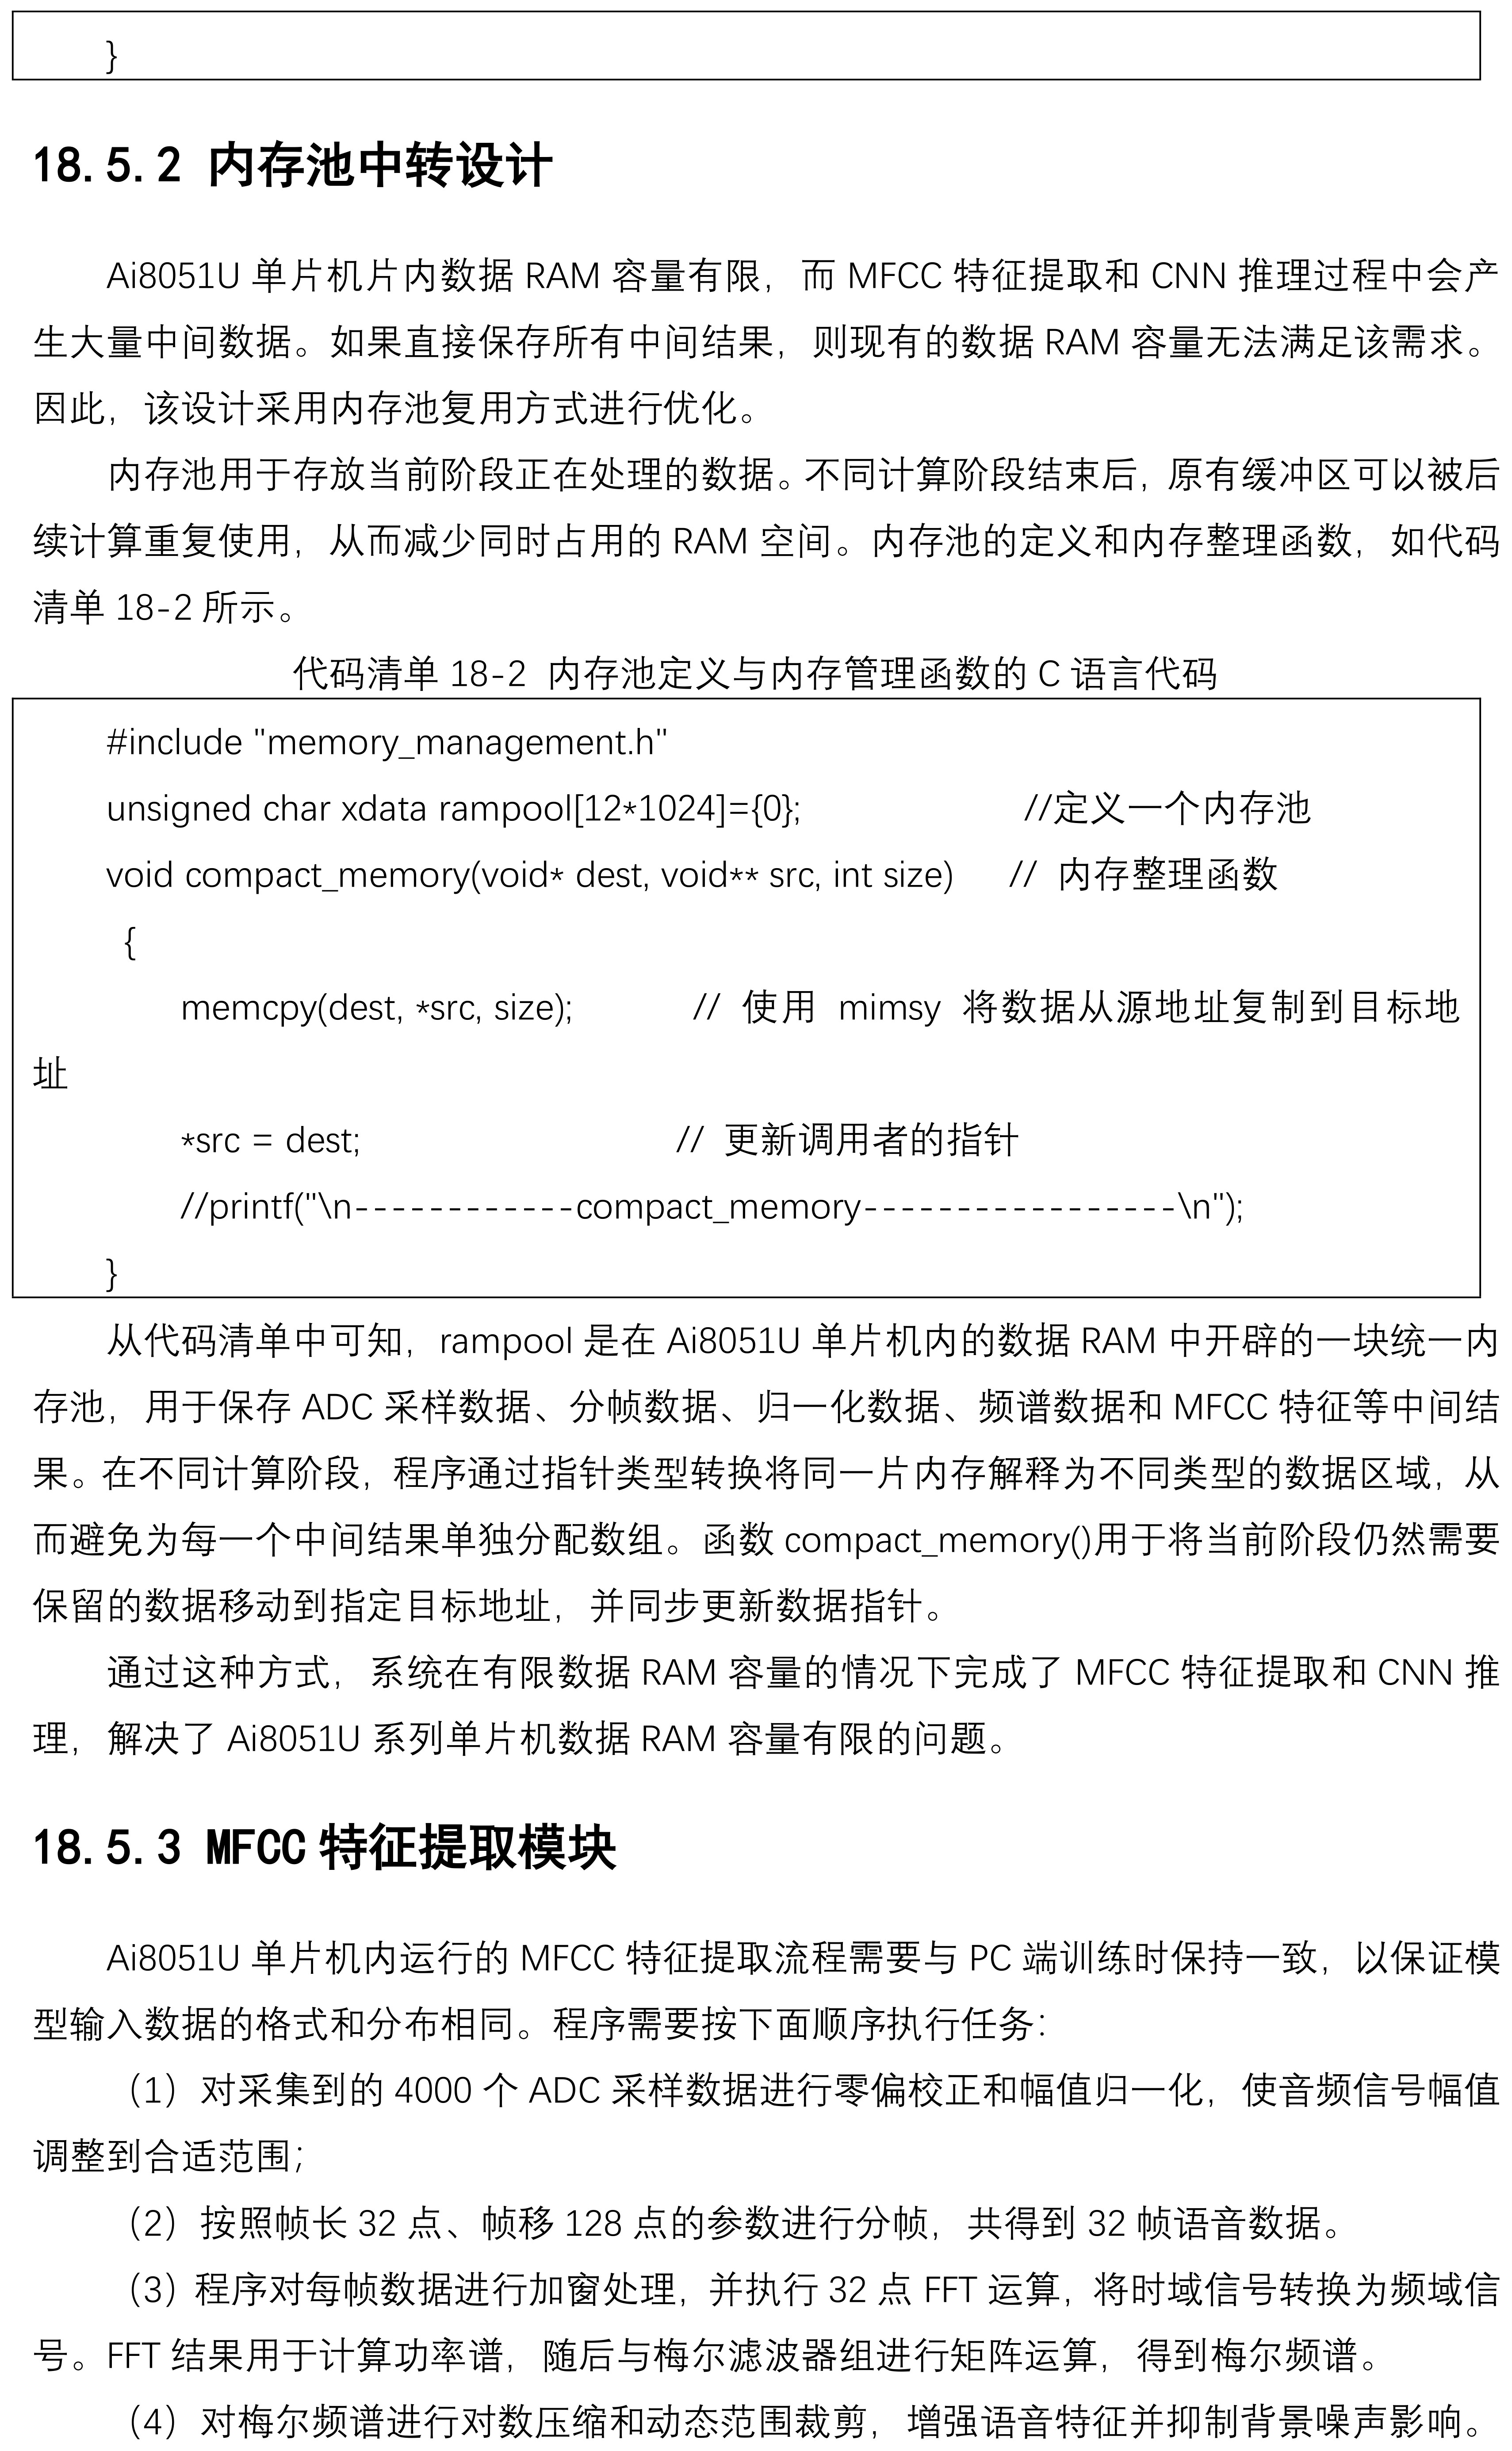
3.2 内存池复用:MFCC + CNN 中间数据量大,在 xdata 开辟 rampool[12*1024] 统一内存池,各阶段通过指针类型转换复用同一片内存,compact_memory() 把需保留数据搬移到目标地址并更新指针,控制 RAM 占用。
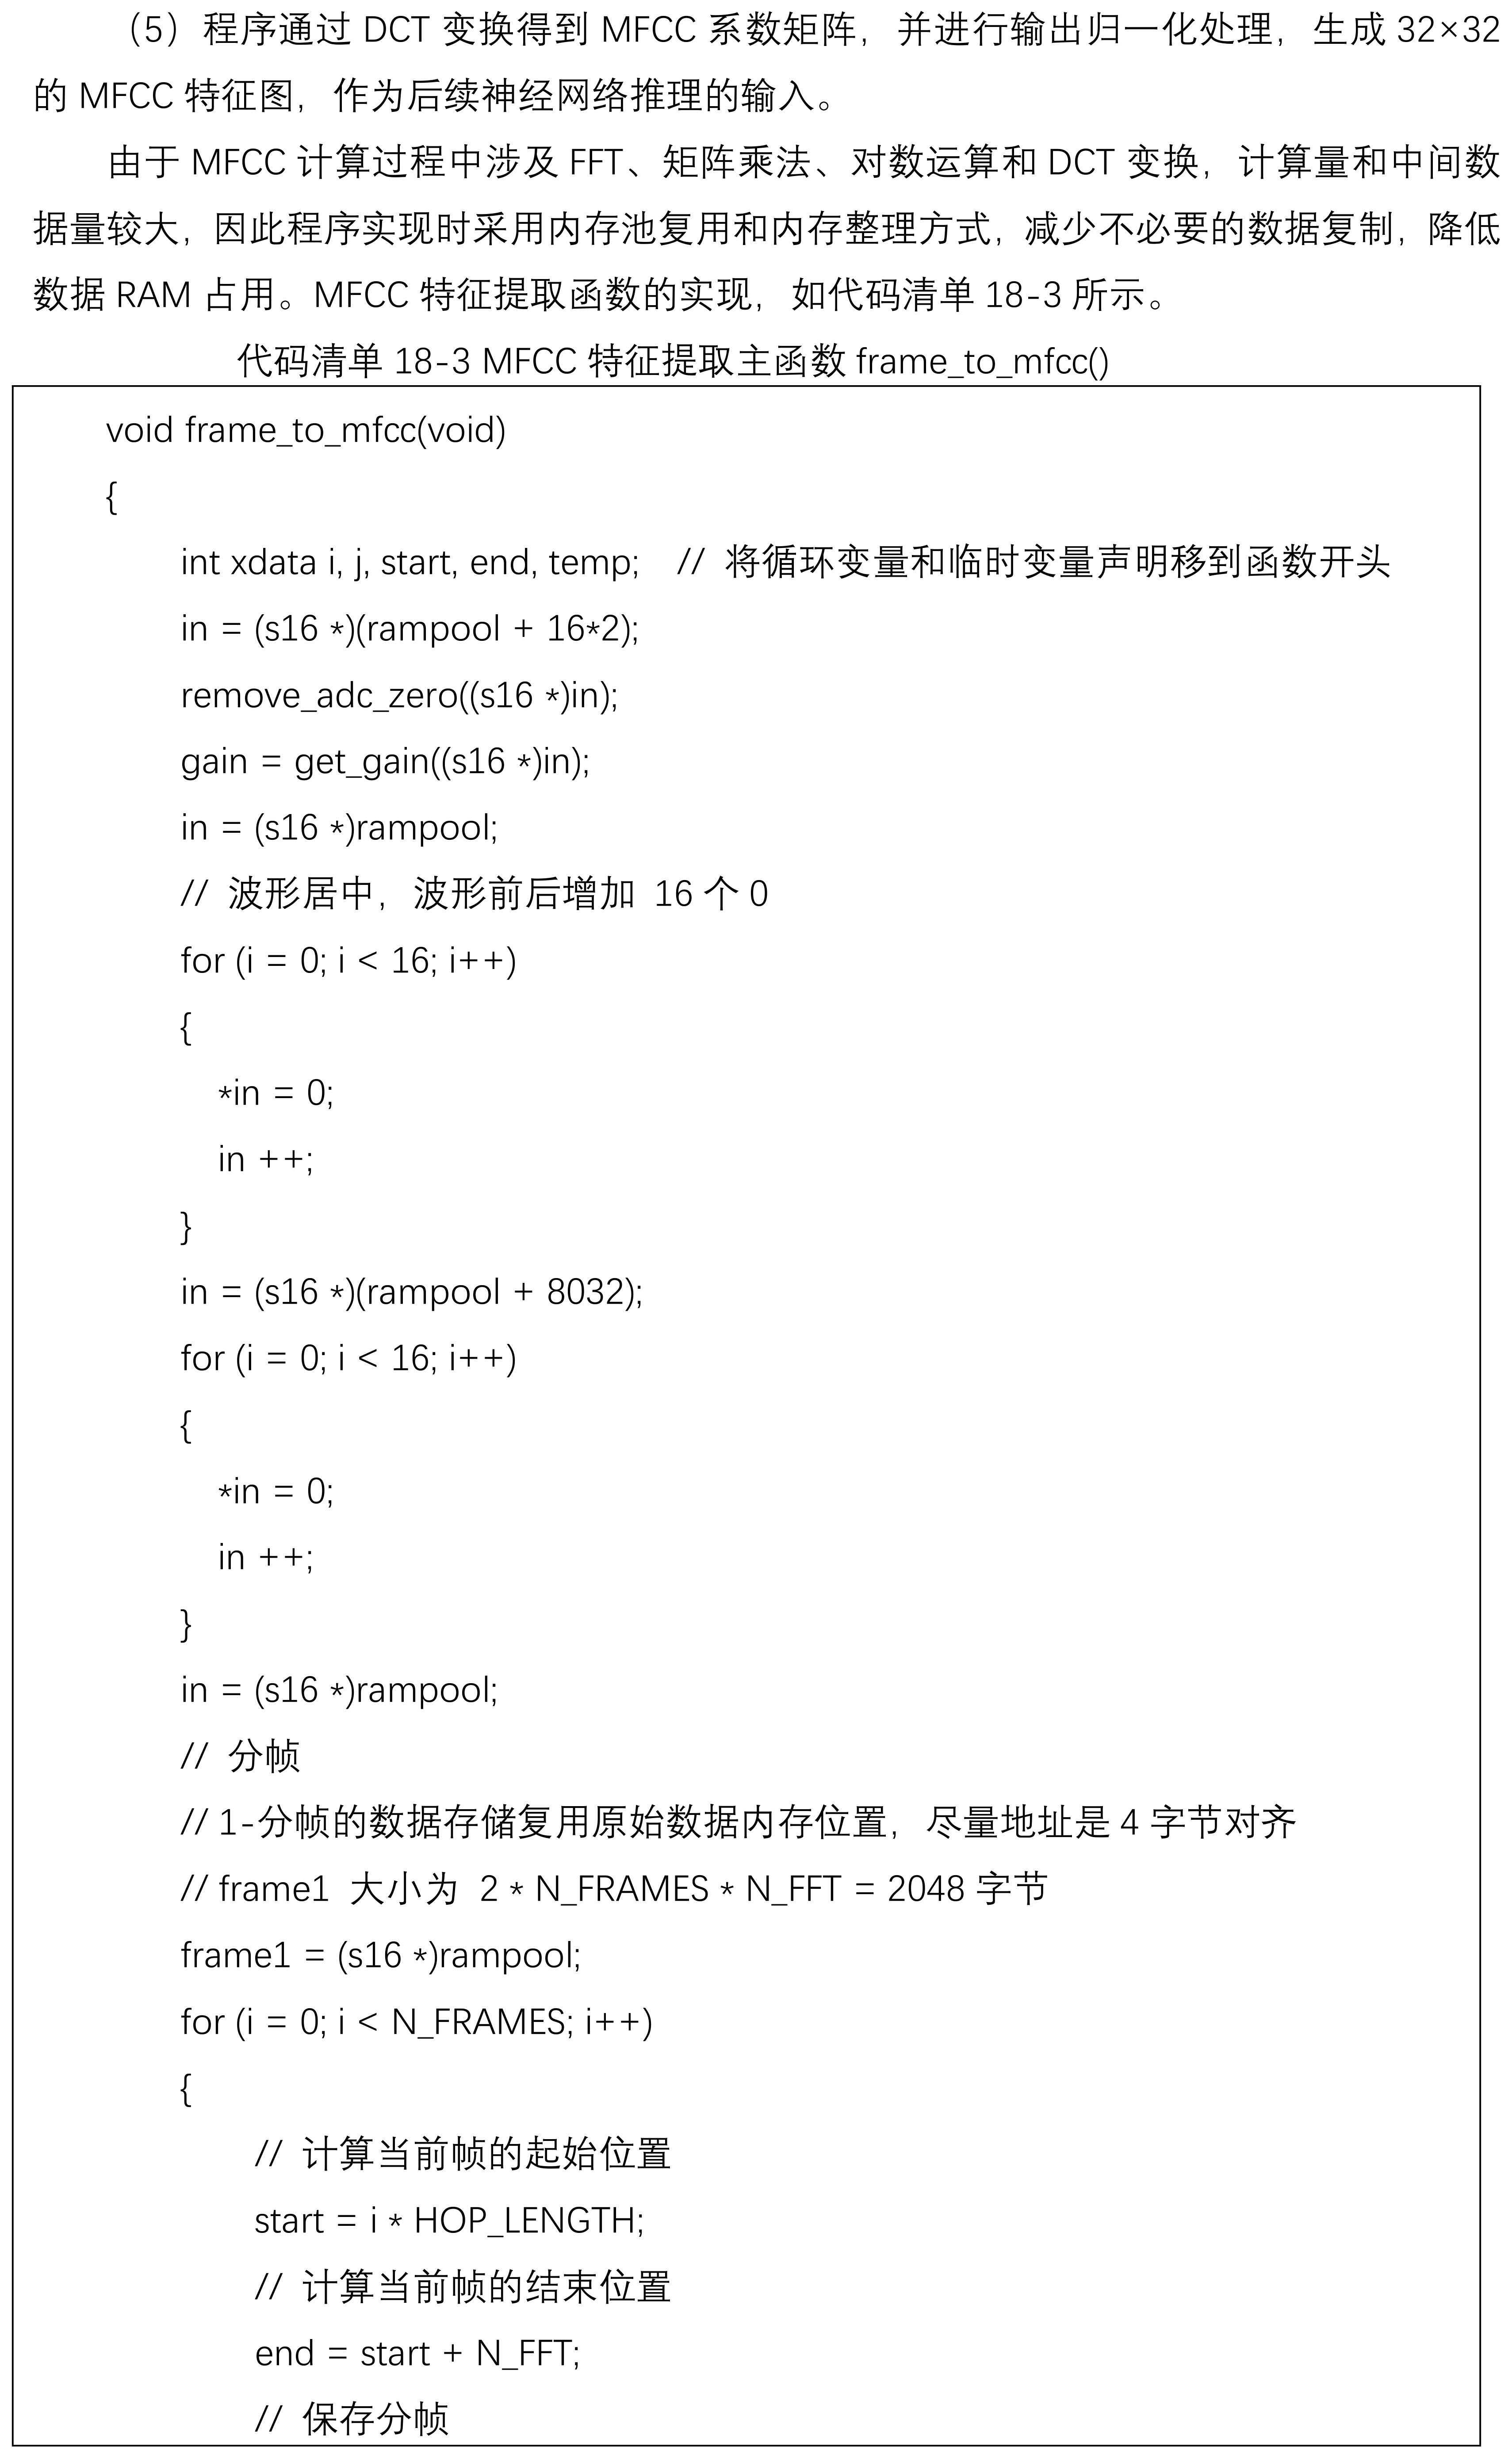
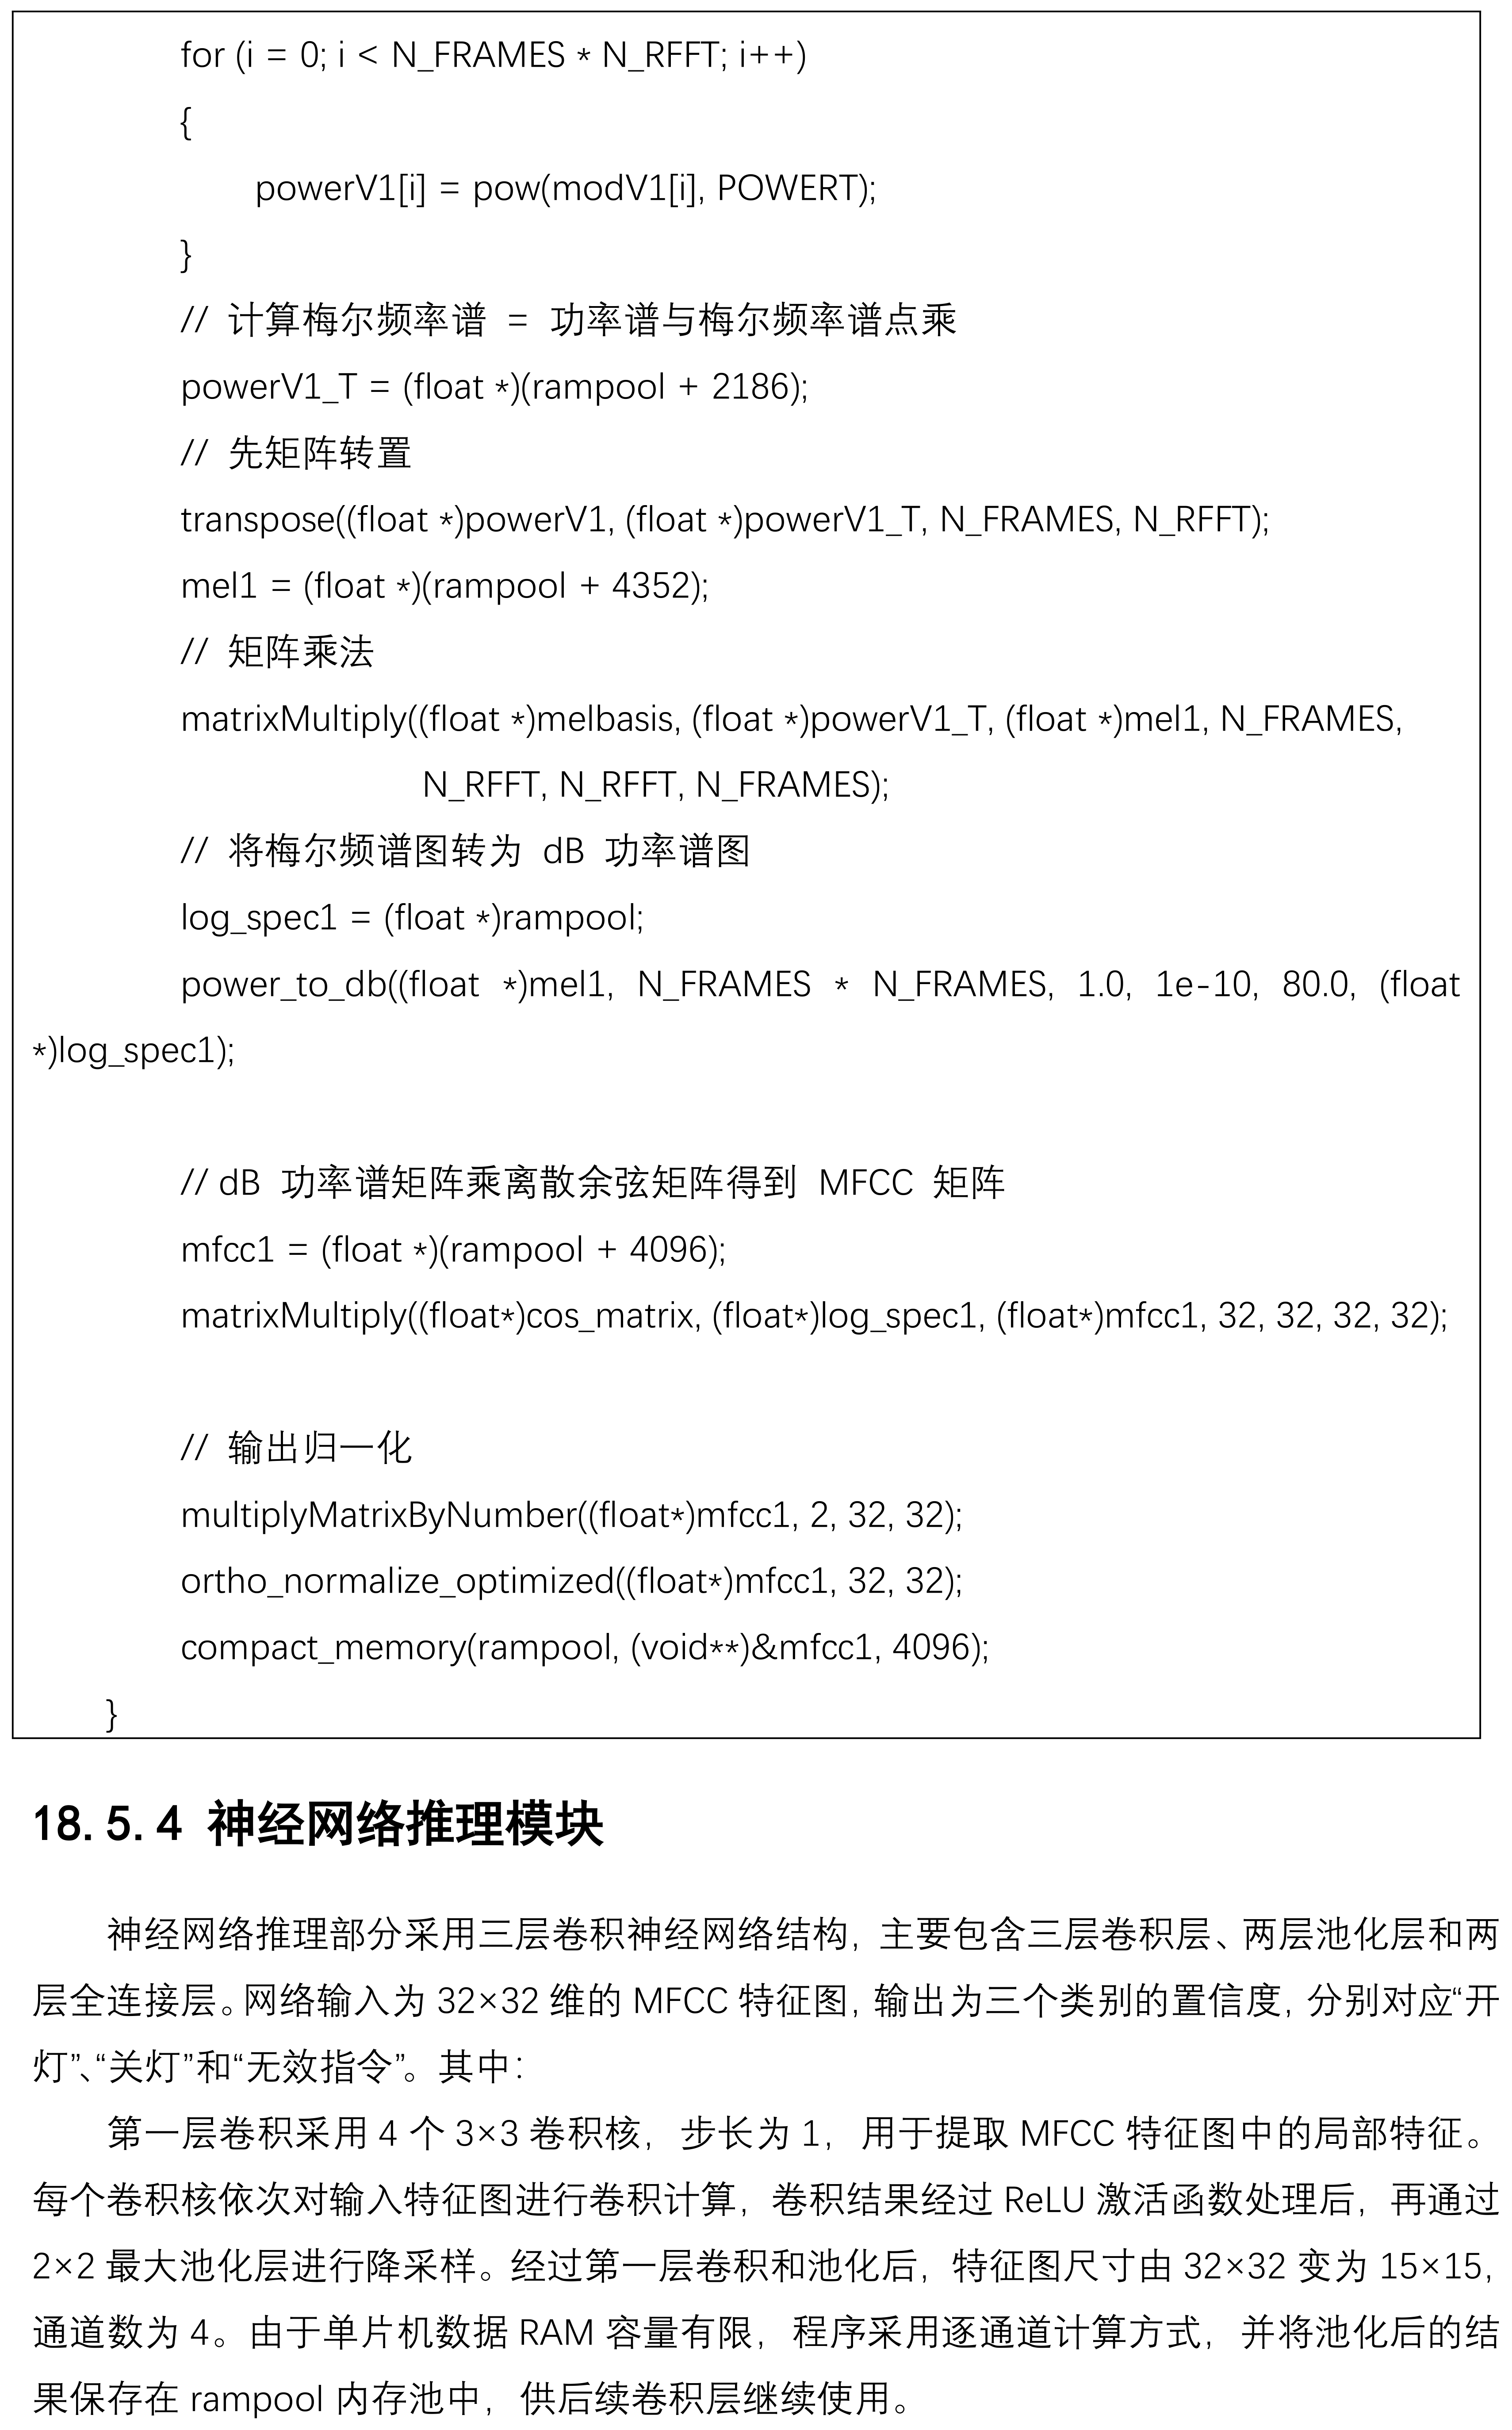
3.3 MFCC 特征提取:主流程:remove_adc_zero 零偏校正 → get_gain 峰值归一化 → 前后各补 16 个零 → 分帧(复用原始数据内存,4 字节对齐)→ 归一化 + 汉明窗 → 每帧 32 点 rfft → 功率谱(pow=2)→ 转置 + 梅尔矩阵乘 → power_to_db(80dB 裁剪)→ 与 DCT 矩阵乘 → 乘 2 幅值补偿 + 行正交归一化,得到 32×32 特征图。
3.4 CNN 推理:Neural_Work():逐通道卷积(Conv2D_single_kernel)→ 加偏置 → ReLU → 2×2 最大池化;第二/三层多通道累加(elementWiseAdd);第三层不池化,输出 4×4×4 → Flatten 64 → 全连接 64→8(ReLU)→ 8→3(Sigmoid)。
3.5 结果判决与 LED 控制:
- if(start) {
- frame_to_mfcc();
- Neural_Work();
- pec[0] = *denseout2_p; // 开灯
- pec[1] = *(denseout2_p + 1); // 关灯
- pec[2] = *(denseout2_p + 2); // 无效
- if((pec[1] > pec[2]) && (pec[2] > pec[0])) { LED = 0; } // 关灯
- else if((pec[2] > pec[1]) && (pec[1] > pec[0])) { LED = 0XFF; } // 开灯
- printf_usb("%f,%f,%f\n", pec[0], pec[1], pec[2]);
- memset(rampool, 0, 8064);
- start = 0; adcen = 0;
- }
无效指令时 LED 保持原状态;处理完清 start 与缓冲,等待下一轮采集。
4. 编译 → 下载 → 验证
- Keil:Project → Open Project 打开 yuyin.uvproj → Project → Build Target 编译
- AiCube-ISP-v6.96V-plus:芯片选 AI8051U-34K64,打开 yuyin.hex,IRC 频率选 40.000
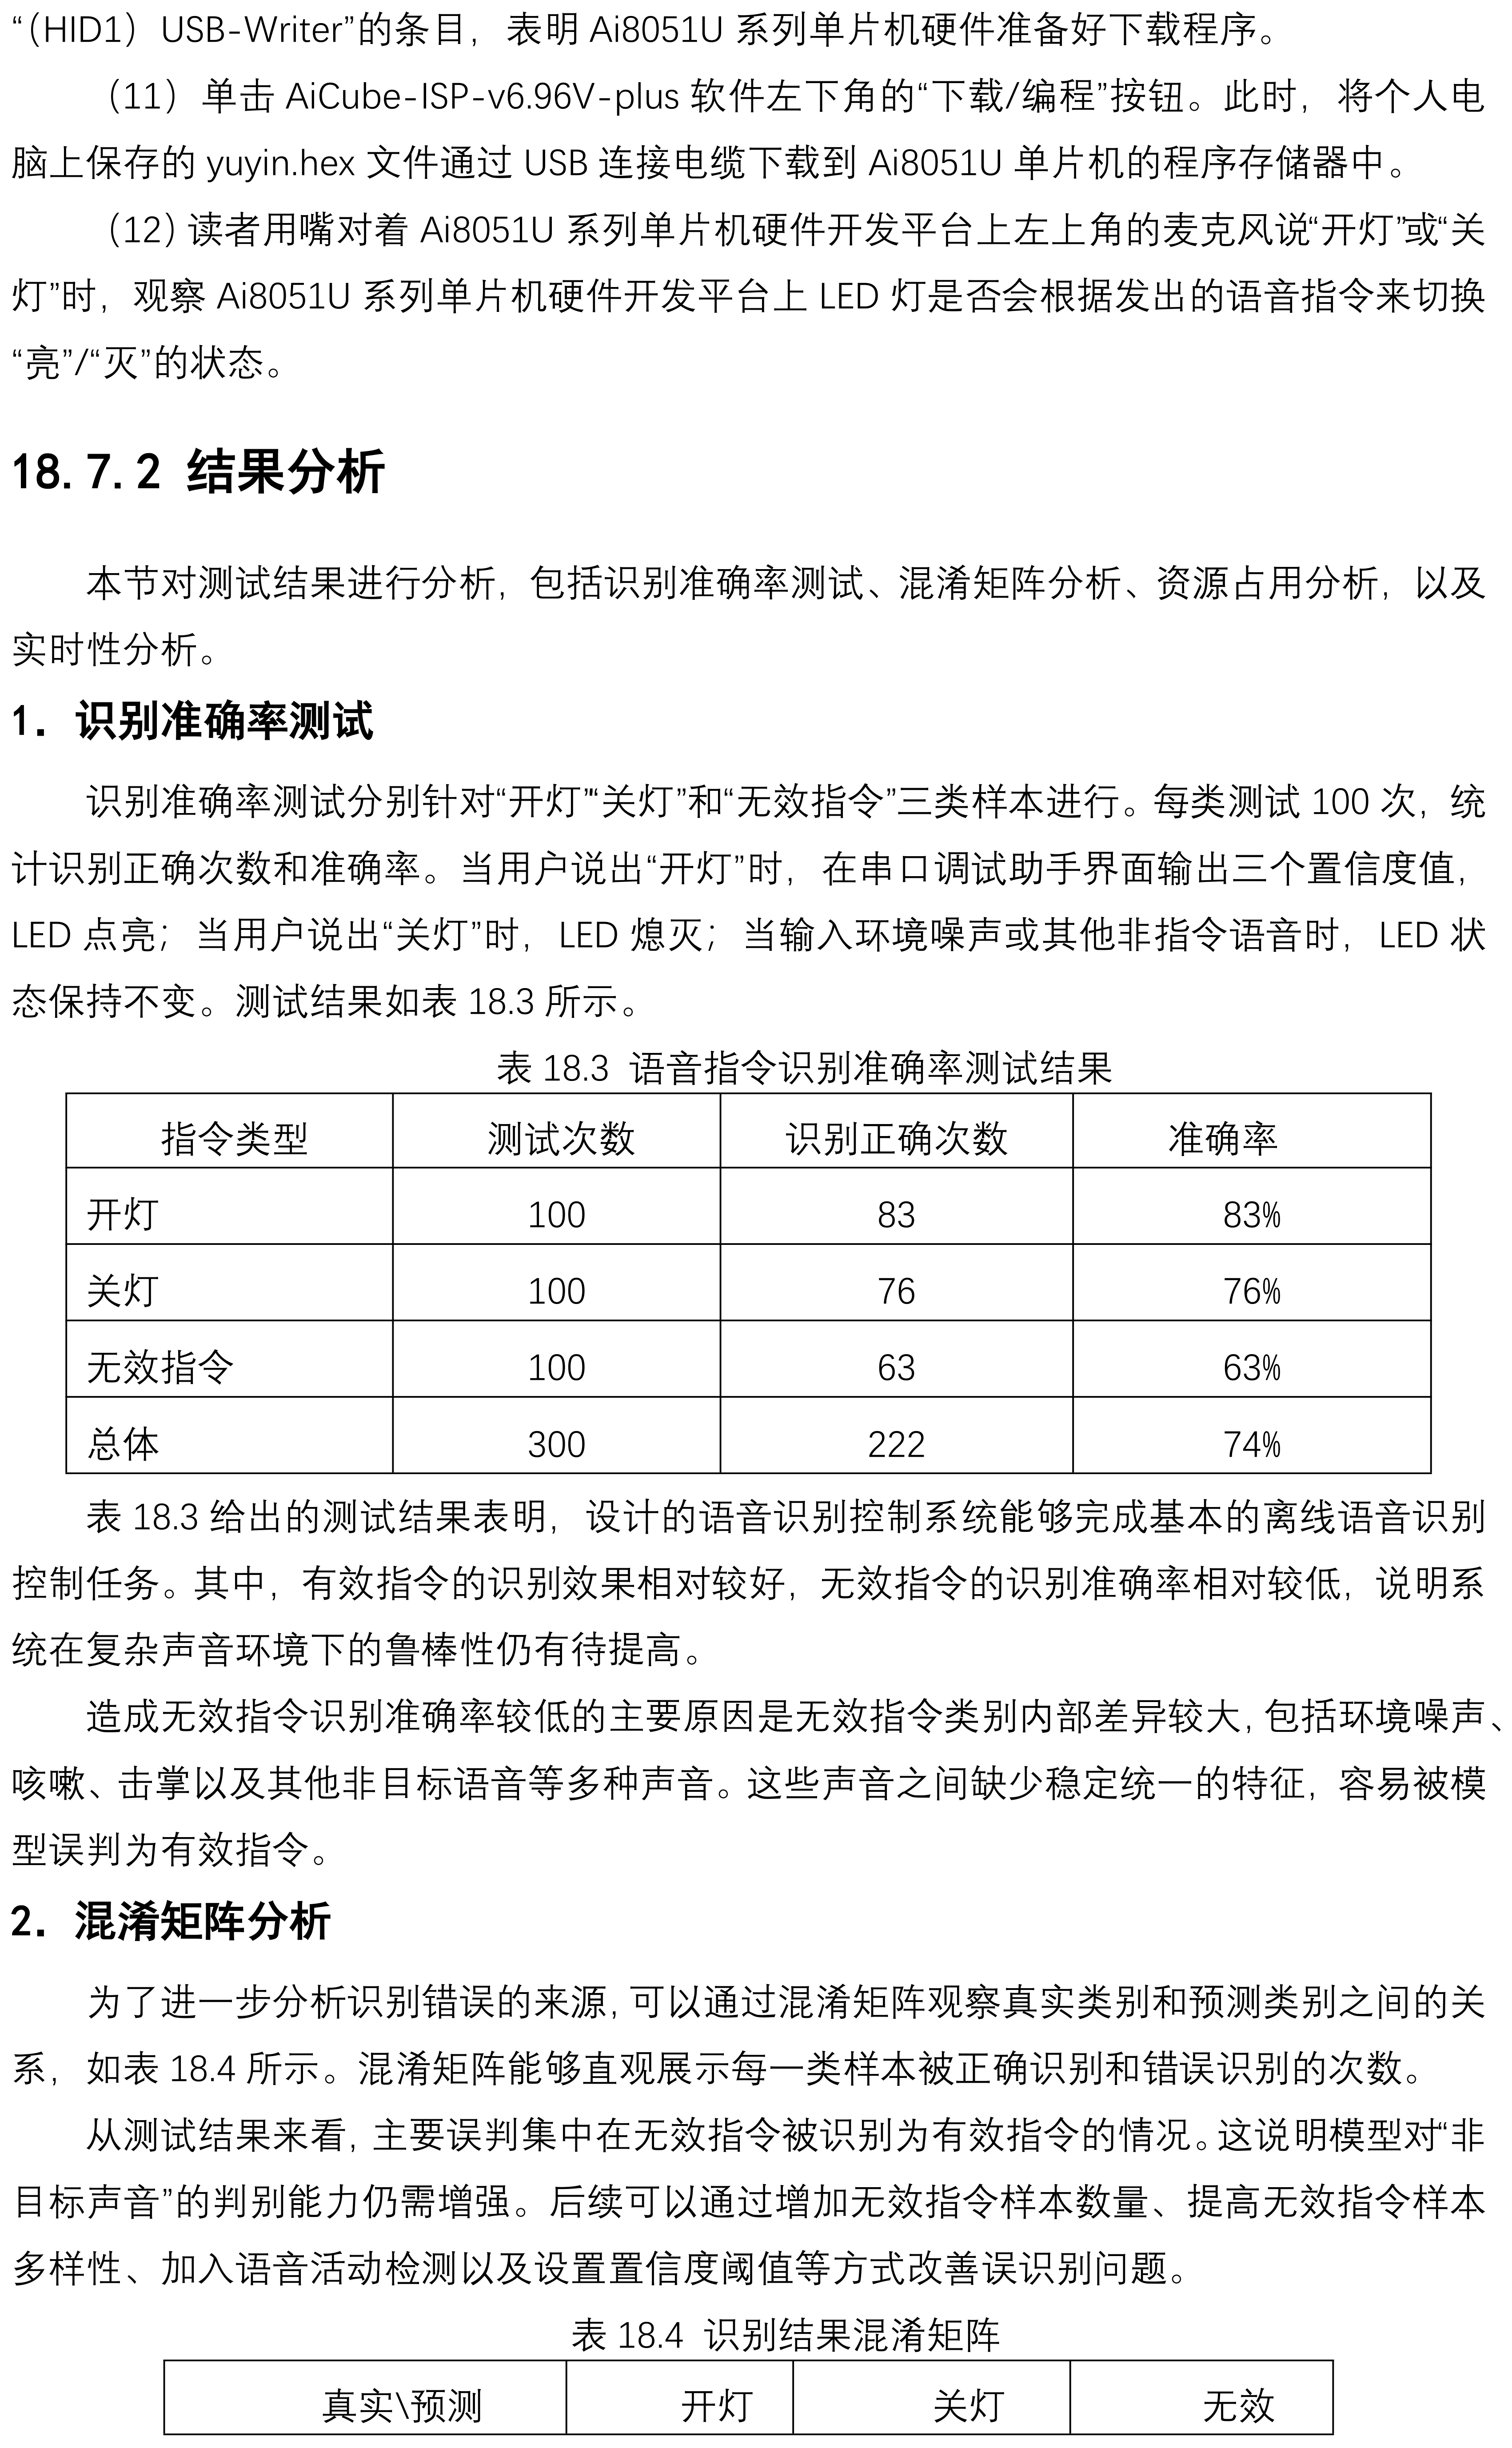
- 同时按住 Power_SW + P32/INT0 约 5 秒进入下载模式,串口出现 (HID1) USB-Writer 后点"下载/编程"
- 对板载 MIC 说"开灯"/"关灯",观察 LED0~7 是否点亮/熄灭
4.2 识别准确率(每类 100 次):
| 指令类型 | 识别正确次数 | 准确率 | | 开灯 | 83 | 83% | | 关灯 | 76 | 76% | | 无效指令 | 63 | 63% | | 总体 | 222 / 300 | 74% |
误判集中于"无效指令被识别为有效指令"(无效类内差异大:噪声/咳嗽/击掌等)。优化方向:扩充无效样本、语音活动检测、设置置信度阈值。
4.3 资源占用与耗时:
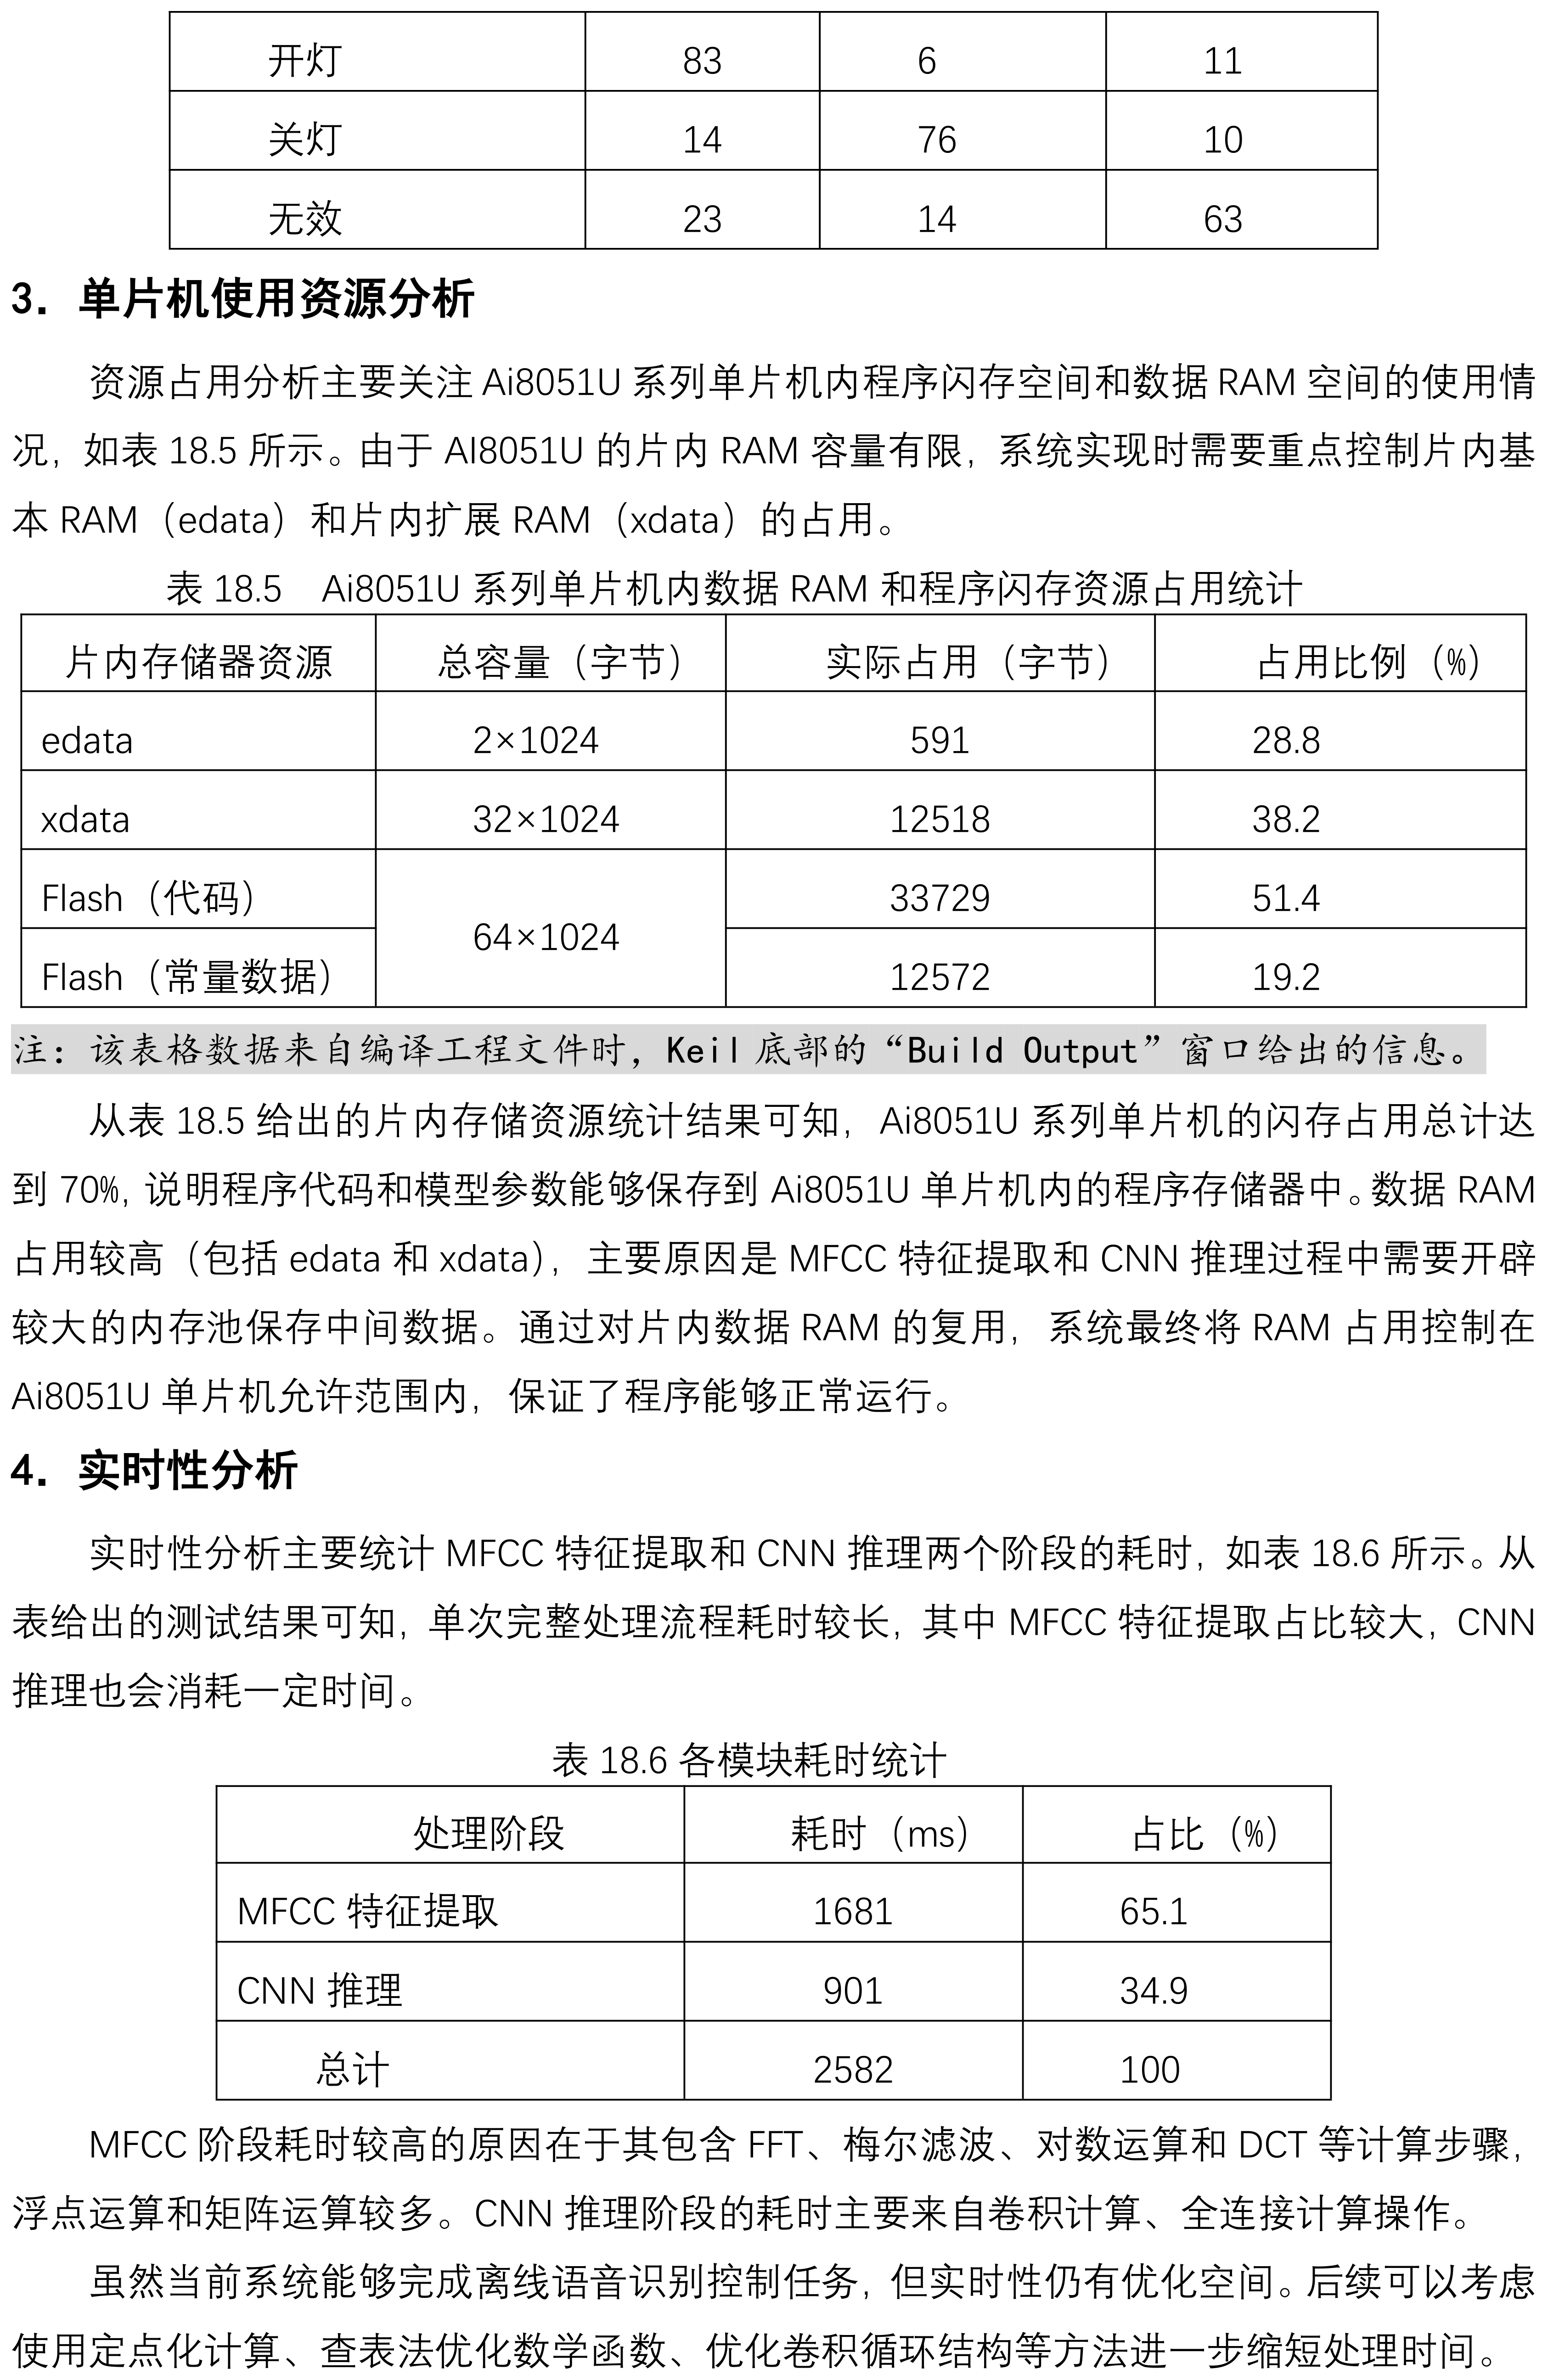
| 片内存储器 | 总容量 | 实际占用 | 占用比例 | | edata | 2 KB | 591 B | 28.8% | | xdata | 32 KB | 12518 B | 38.2% | | Flash(代码) | 64 KB | 33729 B | 51.4% | | Flash(常量) | 64 KB | 12572 B | 19.2% |
| 处理阶段 | 耗时 | 占比 | | MFCC 特征提取 | 1681 ms | 65.1% | | CNN 推理 | 901 ms | 34.9% |
优化方向:定点化运算替代浮点、窗函数/梅尔滤波/DCT 矩阵预存为常量表查表、优化卷积循环减少重复访存。
 example.zip
(168.46 MB, 下载次数: 118)
|  |手机版|深圳国芯人工智能有限公司
( 粤ICP备2022108929号-2 )


 已绑定手机
 发表于 2026-8-4 10:36:43








 发表于 2026-8-4 12:55:44

 发表于 2026-8-4 19:43:25